Qwen3.8-Omni-Flash abbatte i costi per token per gli input audio e video fino al 98%
Alibaba porta avanti l’evoluzione dei modelli multimodali con Qwen3.8-Omni-Flash, progettato per trasformare audio e video da semplici contenuti da analizzare in strumenti operativi per agenti IA. Il modello accetta input testuali, immagini, audio e video e dispone di una finestra di contesto da 1 milione di token, combinando capacità di comprensione multimodale con pianificazione, utilizzo di strumenti ed esecuzione di attività articolate.
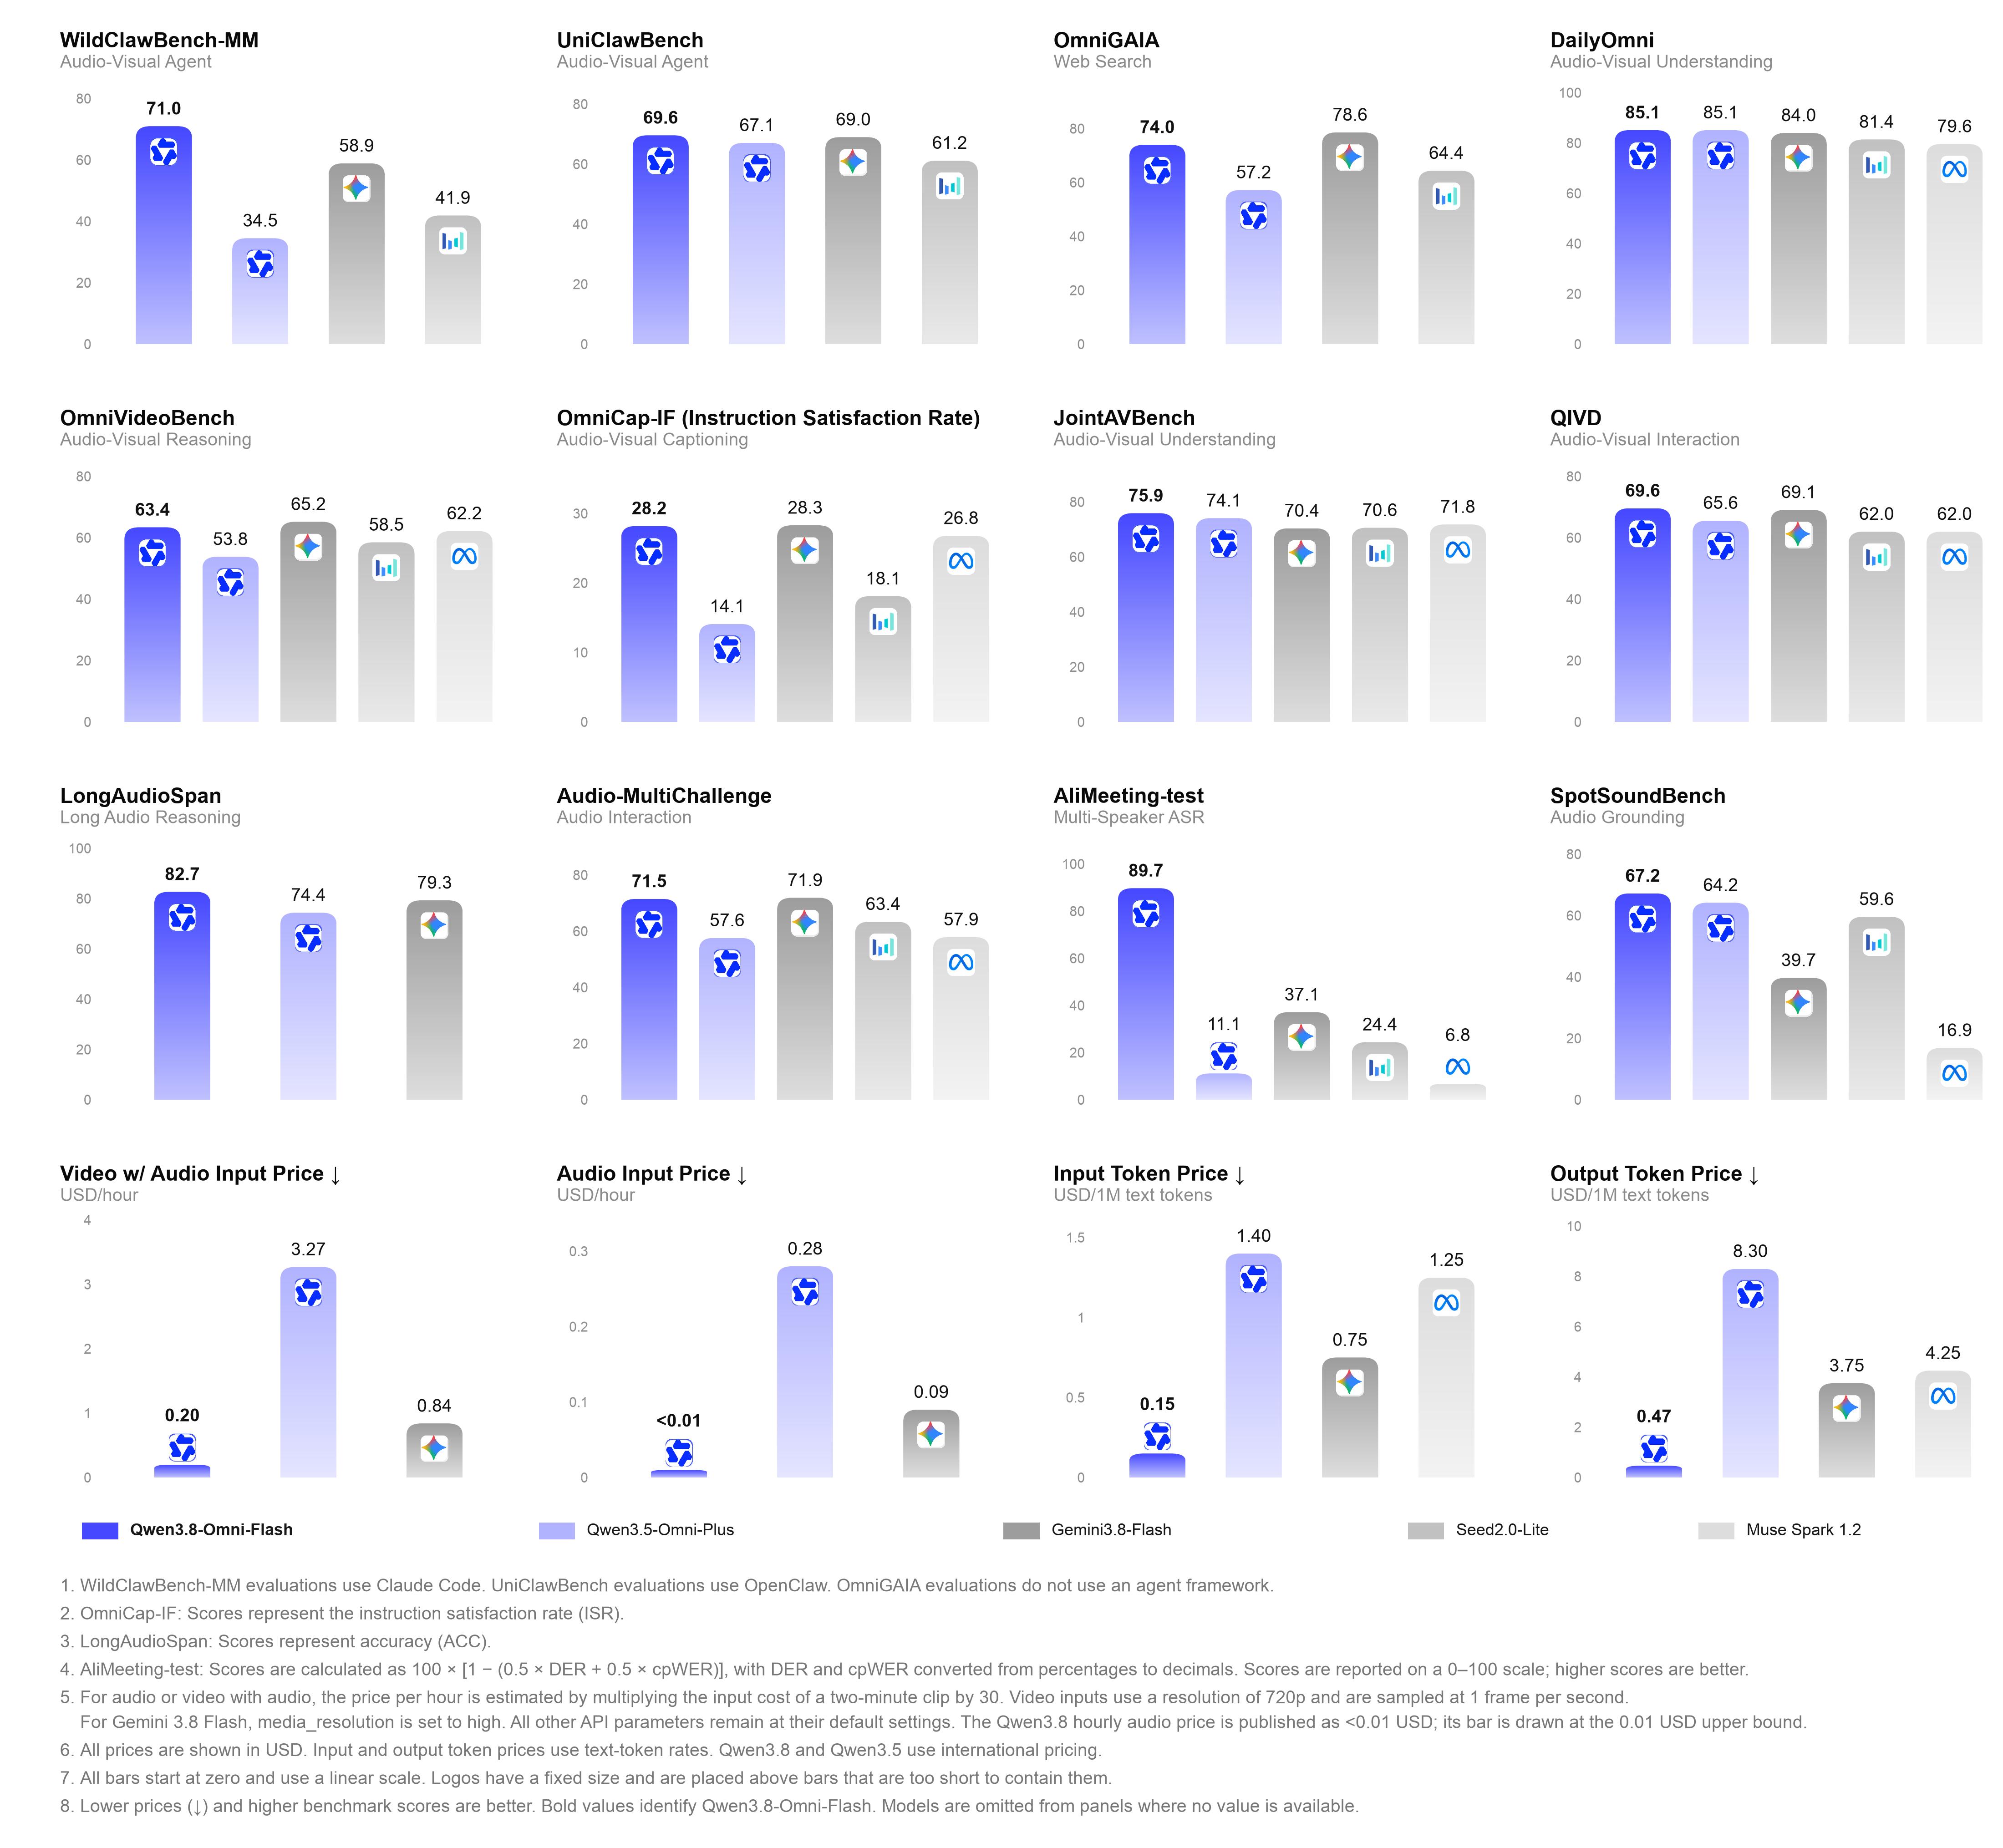
Il salto rispetto ai modelli precedenti riguarda soprattutto gli scenari in cui l’IA deve portare a termine un processo completo. Qwen3.8-Omni-Flash è stato sviluppato per attività come montaggio video, produzione di videoclip musicali, commento cinematografico, sintesi audiovisiva e conversazioni in tempo reale. Secondo Alibaba, su 29 benchmark dedicati ad audio, video e agenti multimodali il nuovo modello migliora mediamente di oltre il 25% rispetto a Qwen3.5-Omni-Plus.
Particolarmente significativo è il miglioramento nei compiti agentici. Su WildClawBench-MM il punteggio cresce di 36,5 punti, mentre su AgenticVBench l’incremento arriva a 22,3 punti, con un risultato di 69,6 su UniClawBench. Alibaba sostiene inoltre che le prestazioni audiovisive si avvicinano a quelle di Gemini 3.8 Flash, mentre nell’audio complessivo Qwen3.8-Omni-Flash riuscirebbe a superare il modello di Google.
Sul fronte dei costi, Alibaba punta a rendere l’elaborazione multimodale molto più accessibile anche nei workflow intensivi. Il prezzo dell’input audio è stato infatti ridotto di oltre il 98% su base oraria, mentre quello dell’input audiovisivo scende di oltre il 93% rispetto a Qwen3.5-Omni-Plus.
Un riduzione che assume quindi particolare rilevanza negli agenti che devono analizzare grandi quantità di registrazioni, meeting o filmati, dove il costo dell’elaborazione dei dati multimediali può diventare rapidamente una voce significativa dell’infrastruttura IA.
Uno degli aspetti più interessanti riguarda l’analisi dei contenuti audiovisivi di lunga durata. Invece di elaborare necessariamente ogni fotogramma di un video, l’agente può partire dalla domanda dell’utente e stabilire autonomamente quali segmenti audio e video siano rilevanti, procedendo con una ricerca delle informazioni per livelli successivi di dettaglio.
Ne deriva un utilizzo più efficiente delle risorse di calcolo. Nei test OmniVideoBench, la modalità agentica porta l’accuratezza da 63,4 a 67,8 punti, riducendo contemporaneamente i token utilizzati per richiesta da 145.736 a 79.117, con un risparmio di circa il 45,7%. Il modello può inoltre modulare il modo in cui descrive un video in base all’obiettivo, dall’individuazione di una scena specifica fino all’analisi dettagliata di inquadrature, illuminazione, movimenti dei personaggi e componente sonora.
Un altro scenario operativo interessante è quello delle riunioni. Qwen3.8-Omni-Flash può infatti gestire fino a un’ora di contenuti audiovisivi, riconoscendo e segmentando i diversi interlocutori, trascrivendo gli interventi e associando correttamente identità e contenuti. L’analisi può quindi produrre verbali, attività da assegnare e indicazioni sui possibili rischi di progetto. Il passaggio successivo è l’azione: collegando il modello agli strumenti software, le informazioni raccolte durante una riunione possono diventare email, task organizzativi o persino codice.
Alibaba accompagna il lancio con Qwen-MM-Plugins, pensato per aggiungere percezione selettiva, utilizzo degli strumenti ed esecuzione di workflow, e con Qwen-Live Harness, un ambiente open source dedicato alle interazioni multimodali continue e in tempo reale.


