L’olandese Axelera AI lancia il chip Europa per inferenza AI e annuncia contratti con le AI Factories
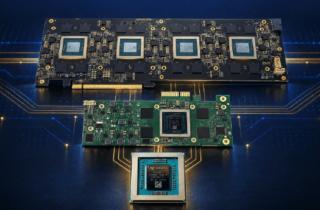
L’azienda olandese Axelera AI ha presentato Europa, una nuova architettura basata su una AIPU (AI Processing Unit) progettata per portare nel mondo enterprise e nei data center l’approccio adottato finora dall’azienda nell’edge computing. Il progetto arriva accompagnato da un ecosistema di partner OEM, ODM e tecnologici che comprende anche sistemi validati da Dell Technologies e Supermicro.
La strategia alla base di Europa parte dal presupposto che dopo la fase in cui l’attenzione in ambito AI era concentrata soprattutto sull’addestramento dei modelli più grandi, l’inferenza sta diventando una componente sempre più rilevante del carico computazionale. Chatbot, agenti AI, modelli multimodali e sistemi di computer vision generano richieste continue e spesso non necessitano della potenza di calcolo dei modelli frontier più complessi.
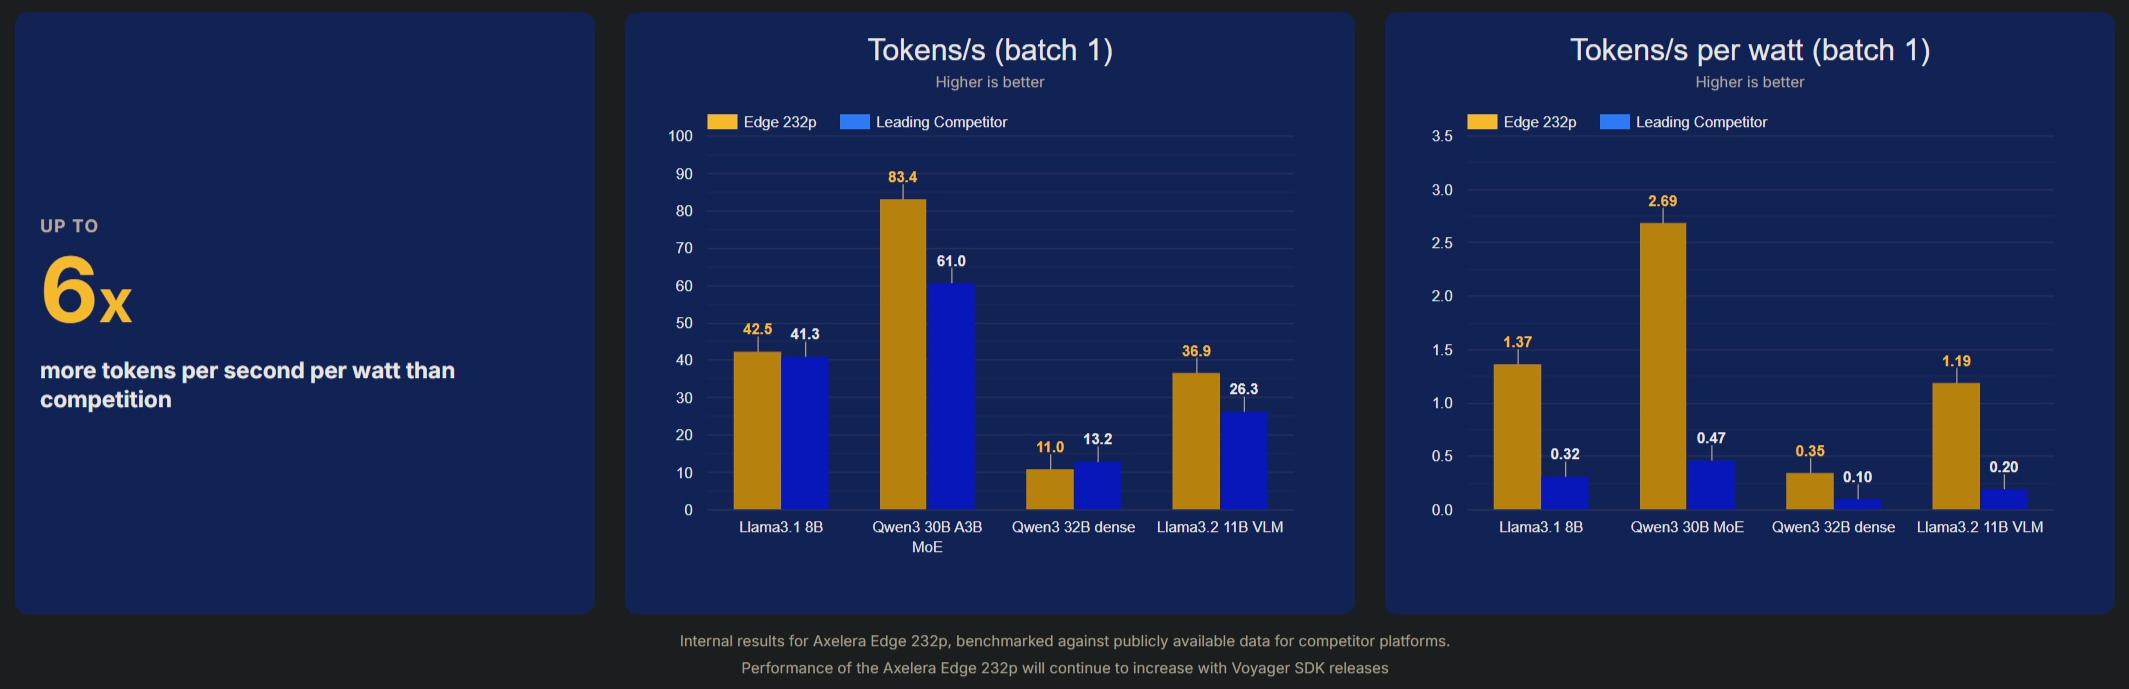
Consumi energetici, costo dell’infrastruttura e disponibilità delle GPU diventano così fattori determinanti e Axelera sostiene che la propria tecnologia possa arrivare a 6 volte più token al secondo per watt rispetto a soluzioni basate su GPU, puntando quindi sull’efficienza energetica come elemento distintivo.
Dall’edge all’enterprise
Europa mantiene i principi architetturali sviluppati da Axelera per Embedded, Edge e Server, ma li adatta a carichi più impegnativi. L’obiettivo è consentire alle aziende di aggiungere capacità di inferenza AI ai server esistenti senza dover necessariamente riprogettare l’intera infrastruttura. La piattaforma può essere adottata in diverse configurazioni. Europa viene infatti proposta come chip, lasciando ai clienti la progettazione delle proprie schede, oppure sotto forma di schede PCIe standard. La Axelera Edge 232p utilizza un formato half-height, half-length, mentre la Axelera Server 250p adotta un formato full-height, full-length.
L’impiego dello standard PCIe è significativo per gli ambienti enterprise, perché permette di integrare gli acceleratori in server convenzionali e aumentare la capacità di elaborazione senza costruire un’infrastruttura completamente proprietaria attorno all’acceleratore.
Efficienza per i carichi di inferenza
I benchmark pubblicati da Axelera mettono in evidenza soprattutto il rapporto tra prestazioni e consumi. Con batch size 1, tipico di molte applicazioni di inferenza interattiva, l’Edge 232p raggiunge 42,5 token al secondo con Llama 3.1 8B, contro 41,3 della piattaforma concorrente considerata nel confronto. Con Qwen3 30B A3B MoE il dato sale a 83,4 contro 61 token al secondo, mentre con Llama 3.2 11B VLM il risultato dichiarato è di 36,9 contro 26,3.
Il vantaggio risulta più marcato quando si normalizzano i risultati in funzione dell’energia consumata. Axelera indica 1,37 token/s per watt con Llama 3.1 8B contro 0,32 della soluzione concorrente e 2,69 contro 0,47 con Qwen3 30B MoE. Con Llama 3.2 11B VLM il rapporto dichiarato è 1,19 contro 0,2 token/s per watt.
Sono risultati interni di Axelera relativi all’Edge 232p e confrontati con dati pubblicamente disponibili per piattaforme concorrenti, quindi non equivalgono a un benchmark indipendente condotto secondo un protocollo comune. L’azienda prevede inoltre ulteriori incrementi prestazionali attraverso le future versioni del Voyager SDK.
Il fattore sovranità dei dati
Una delle applicazioni più interessanti di Europa riguarda settori come servizi finanziari, sanità, studi legali, difesa e pubblica amministrazione, che devono spesso rispettare vincoli stringenti in materia di sicurezza, conformità e sovranità dei dati. Da questo punto di vista, un acceleratore installato direttamente nell’infrastruttura aziendale permette di mantenere localmente dati e workload, riducendo la dipendenza dai servizi cloud per l’inferenza. È una tendenza che si inserisce anche nel più ampio dibattito europeo sull’autonomia digitale e sulla necessità di costruire capacità computazionali controllabili all’interno dell’Unione.
Non a caso Dell Technologies sta collaborando con Axelera AI e l’integratore E4 per infrastrutture destinate alle AI Factory europee in Italia e Lussemburgo. L’iniziativa collega quindi l’accelerazione AI direttamente ai programmi europei dedicati alla disponibilità di capacità di calcolo per l’intelligenza artificiale. Sul versante software, Axelera punta invece sul Voyager Toolchain, pensato per ottimizzare i modelli esistenti e accompagnarli dalla fase di sviluppo alla distribuzione. A questo si aggiunge Voyager Wingman, una piattaforma agentica destinata alla creazione, migrazione e ottimizzazione delle pipeline di inferenza.
Particolare attenzione è stata infine dedicata al supporto dei modelli, storicamente uno dei punti critici per gli acceleratori AI alternativi alle GPU. Axelera ha presentato AxeleraScript (AxScript), un approccio proprietario alla compilazione dei modelli che mira a semplificare la trasformazione dei workload di inferenza per l’hardware dell’azienda, cercando di ridurre uno degli ostacoli principali alla loro adozione in produzione.


