Huawei anticipa le NPU Ascend 960DT. Sarà l’alternativa cinese al ban dei prodotti NVIDIA?
All’evento Huawei Connect 2026 di Shanghai, l’azienda cinese ha annunciato che la NPU Ascend 960DT arriverà nel primo trimestre del 2027, tre trimestri prima rispetto alla precedente tabella di marcia, con la variante 960PR che seguirà invece nel terzo trimestre. La mossa si inserisce in una strategia molto più ampia, nella quale Huawei punta a costruire infrastrutture capaci di collegare migliaia o, nel prossimo futuro, milioni di NPU.
La NPU 960DT è progettata per training e decode dell’inferenza e rappresenta un salto importante rispetto alla generazione Ascend 950. Huawei indica infatti fino a 4 PFLOPS in FP4 e 2 PFLOPS in FP8, accompagnati da un massimo di 288 GB di memoria e una bandwidth di memoria che arriva a 9,6 TB/s. Sono numeri che vanno letti soprattutto nel contesto del mercato cinese visto che le GPU Nvidia e AMD più recenti, caratterizzate da capacità di calcolo sensibilmente superiori, non sono disponibili in Cina, mentre le restrizioni sulle esportazioni di acceleratori avanzati hanno reso la produzione locale una questione strategica oltre che tecnologica.
Il confronto diretto con i chip occidentali racconta comunque una situazione meno semplice. L’Ascend 960 non raggiunge i livelli di calcolo promessi dalle piattaforme Nvidia Rubin di nuova generazione e dagli acceleratori AMD più recenti. Il punto è però che, nell’addestramento e nell’inferenza dei modelli linguistici di grandi dimensioni, il dato del singolo acceleratore dice soltanto una parte della storia. Quando infatti i modelli vengono distribuiti su migliaia di processori, diventano determinanti anche memoria, interconnessioni, latenza e capacità di far lavorare il sistema come un’unica macchina.
È proprio qui che Huawei sta concentrando una parte significativa degli investimenti. Il nuovo sistema Atlas 960E SuperPoD utilizza Ascend 960 e può arrivare a 4.096 NPU, mentre l’interconnessione viene affidata a una nuova generazione di tecnologia Near-Packaged Optics (NPO) denominata Hi-ONE. Huawei dichiara per il sistema una capacità complessiva fino a 8 EFLOPS FP8 e 1 petabyte di memoria, con un livello di disponibilità dichiarato del 99,8%.
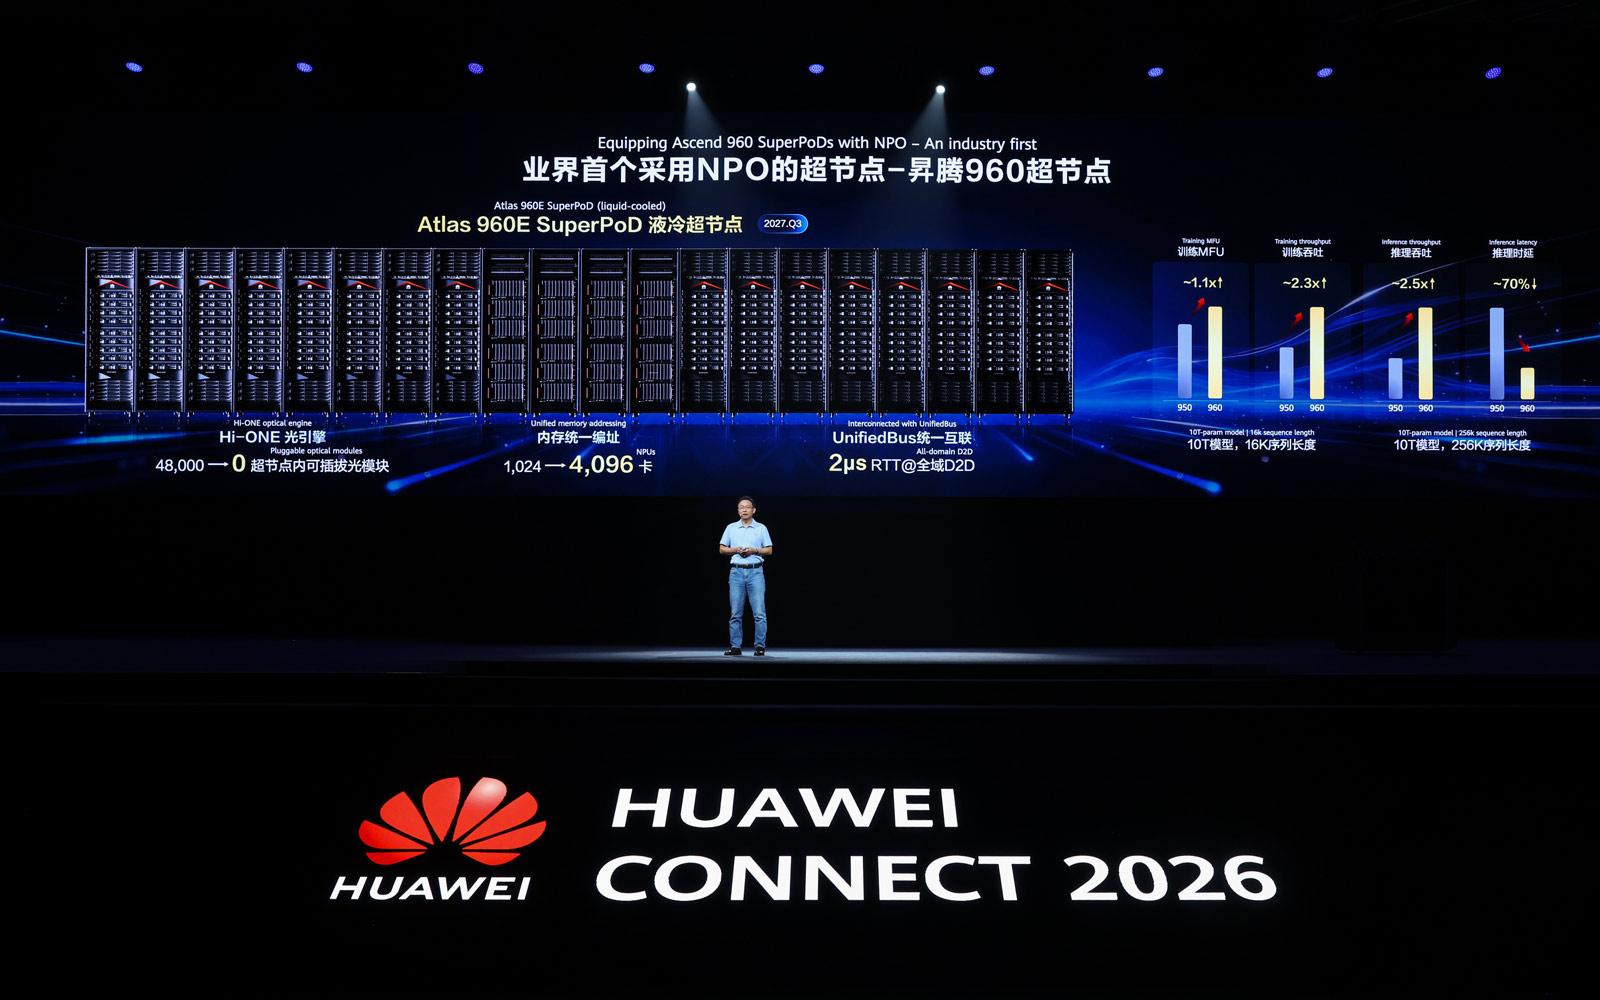
Huawei sostiene inoltre che Hi-ONE possa sostituire 48.000 moduli ottici da 800 Gbps con 5.500 unità, riducendo il consumo energetico di oltre 550 kW. La tecnologia offre inoltre una capacità di trasmissione dichiarata di 7,2 Tbit/s per singolo motore ottico ed è stata presentata come una soluzione pensata per la produzione su larga scala.
La seconda versione dell’acceleratore, Ascend 960PR, segue una filosofia differente. Il suffisso PR identifica l’ottimizzazione per la fase di prefill dell’inferenza e per i workload dei recommender. Qui Huawei aumenta il calcolo a bassa precisione fino a 8 PFLOPS FP4, riducendo però la memoria a 192 GB e la relativa bandwidth a 2,4 TB/s. Il chip è concepito per lavorare insieme alla 960DT, con la versione PR che gestisce la fase iniziale dell’inferenza mentre la DT si occupa del decode e della generazione dei token. È un’architettura eterogenea che cerca di assegnare ciascun carico al tipo di acceleratore più adatto.
Dietro questi prodotti c’è poi UnifiedBus, l’architettura di interconnessione proprietaria con cui Huawei vuole superare il tradizionale modello di cluster formato da server relativamente indipendenti. L’obiettivo è collegare CPU, NPU, memoria, storage, schede di rete e switch attraverso un’infrastruttura comune, arrivando a sistemi nei quali un numero enorme di processori possa comportarsi come una singola macchina. Huawei ha presentato questo approccio all’interno della nuova architettura Peerium, progettata per scalare fino al livello del milione di processori.
Le ambizioni sono quindi decisamente superiori al semplice inseguimento delle GPU Nvidia. Huawei afferma di aver già portato un SuperPoD basato su Ascend 950 a 4.096 acceleratori e indica come obiettivo cluster da 512.000 NPU, con una possibile evoluzione verso configurazioni da un milione di unità. Si tratta però di distinguere ciò che è stato effettivamente dimostrato da ciò che appartiene alla roadmap, visto che la configurazione da un milione di processori resta un obiettivo architetturale, mentre il sistema Ascend 960 a 4.096 NPU è attualmente in fase di test.
La roadmap prosegue con Ascend 970 nel 2028 e Ascend 980 nel 2029. Huawei prevede una progressione annuale con un raddoppio delle capacità di calcolo e incrementi paralleli per memoria e interconnessioni. L’azienda sta quindi cercando di costruire un’alternativa completa all’ecosistema occidentale, con la quale il vantaggio competitivo viene affidato soprattutto all’integrazione tra acceleratori, memoria, networking, software e architettura dei supercluster.


