Google presenta Gemini 4 Argon, ma per ora lo possono usare solo pochi partner
Google ha annunciato Gemini 4 Argon, il modello che inaugura la generazione Gemini 4 ed è destinato soprattutto allo sviluppo software, alle attività professionali in ambito legale e finanziario e alla difesa informatica. Per ora è distribuito solo a un gruppo di aziende partner che operano nella sicurezza e sono state selezionate attraverso il Fairwind Program. Non è ancora stata comunicata una data per rilascio a sviluppatori, aziende e utenti finali.
Argon arriva dopo mesi di attesa. A maggio l’Amministratore Delegato di Google, Sundar Pichai, aveva indicato giugno come data del successivo grande rilascio, che tutti si aspettavano fosse Gemini 3.5 Pro. Quel modello non è mai uscito, e secondo quanto riferito da un portavoce a Reuters, non uscirà mai. Nel frattempo l’azienda ha presentato modelli più piccoli della famiglia Flash, per poi passare direttamente ad Argon nella fascia alta.
Anche sul piano organizzativo sono stati mesi turbolenti. Google ha riorganizzato il laboratorio DeepMind, dopo che il fondatore e CEO Demis Hassabis si è fatto da parte e diversi responsabili del progetto Gemini hanno lasciato l’azienda. Google non ha attribuito i ritardi né a questi cambiamenti né ai test di sicurezza.
Google giustifica la distribuzione per fasi con il livello delle capacità del modello e la sua potenziale pericolosità, una narrativa che finora era stata spinta soprattutto da Anthropic e OpenAI. nel post di annuncio firmato da Koray Kavukcuoglu, Senior Vice President di Google DeepMind e Chief AI Architect di Google, l’azienda dichiara di partecipare attivamente al processo volontario con cui il governo statunitense ottiene l’accesso ai modelli prima del rilascio (ieri abbiamo dato notizia dell’accordo volontario e non vincolante sigliato dai big dell’IA alla Casa Bianca), mentre amplia gradualmente la platea. Il rilascio a sviluppatori, aziende e consumatori partirà dai clienti a pagamento delle API e dagli abbonati al piano Google AI Ultra.
Un milione di token in uscita, ma a che prezzo?
La novità tecnica più evidente riguarda la lunghezza delle risposte. Il limite di output sale a un milione di token, contro i 64.000 della generazione precedente. Questo dato non va confuso con quello della finestra di contesto, cioè la quantità di testo che il modello può ricevere in ingresso (anche in quel caso, Google era stata la prima ad estendere la capacità fino a un milione di token). Quella che è stata aumentata in questo caso è la quantità di token che Gemini 4 Argon può produrre in un solo passaggio. Secondo Google, la possibilità di generare centinaia di migliaia di token in un’unica sequenza renderà il ragionamento più profondo e permetterà di risolvere problemi più difficili in un colpo solo.
Il rovescio della medaglia è il consumo di token necessari a svolgere ogni singolo task, un parametro che sta diventando sempre più importante per chi sviluppa agenti che possono lavorare in autonomia per molto tempo consumando risorse in modo poco prevedibile.
Il listino introduttivo prevede 2 dollari per milione di token in ingresso e 10 dollari in uscita, con uno sconto del 95% sui token già presenti nella cache. Alla fine del periodo introduttivo i prezzi saliranno a 4 e 20 dollari. La durata del periodo promozionale non è indicata nel comunicato. Questa quindi è la spesa massima che può essere generata con una singola richiesta fatta a Gemini 4 Argon.
Primati dichiarati, e qualche ritardo
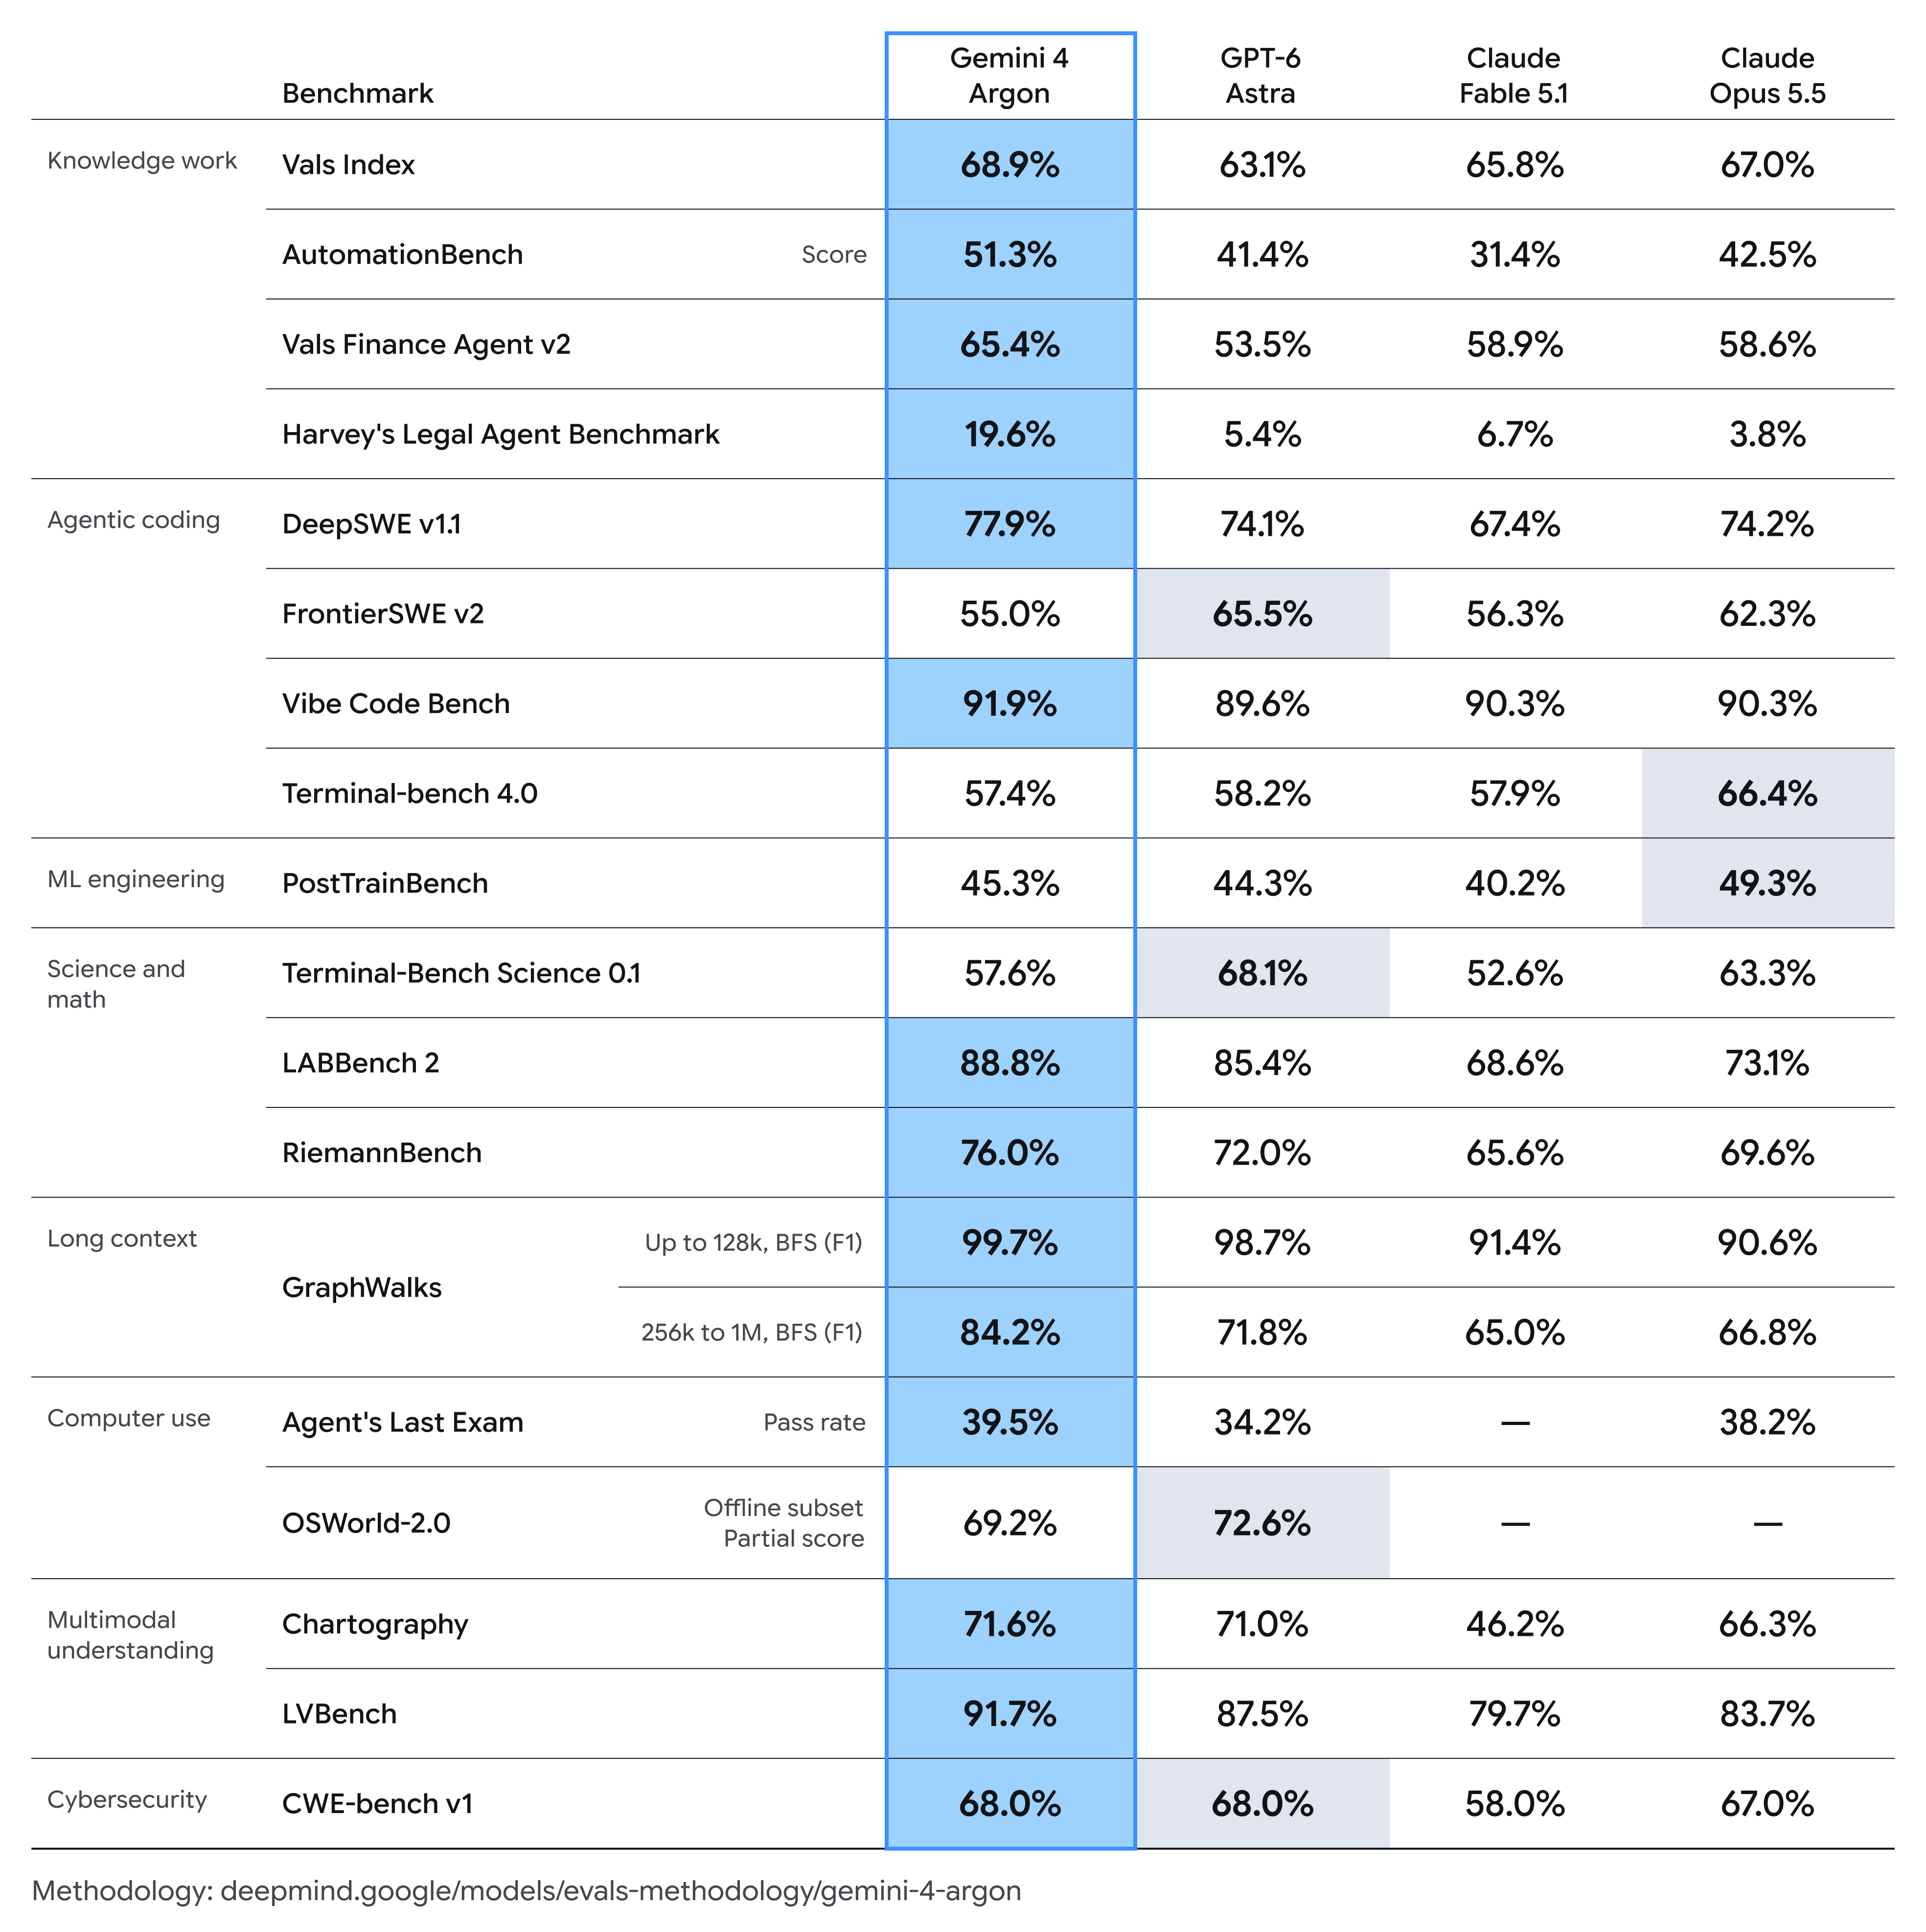
Sulla programmazione, Google rivendica il 77,9% su DeepSWE v1.1, benchmark che misura compiti di sviluppo del software reali e di lunga durata. Secondo i numeri diffusi dall’azienda, Claude Opus 5.5 si ferma al 74,2% e GPT-6 Astra al 74,1%. Il quadro però non è uniforme. Argon resta indietro su due dei quattro benchmark di programmazione inclusi nello stesso annuncio di Google.
(clic per ingrandire)
Fuori dal codice, Argon guida il Vals Index, che misura l’impatto economico su finanza, programmazione, attività legali e fiscali. Google dichiara risultati di vertice anche su benchmark dedicati alla ricerca finanziaria e alla redazione di atti legali. Su AutomationBench di Zapier, che misura l’esecuzione completa di processi aziendali, Argon è primo con il 51,3%. Sulla comprensione di video lunghi (LVBench) il punteggio è del 91,7%. Tutti i risultati sono dichiarati da Google e al momento, non essendo il modello pubblico, non possono essere confermati in modo indipendente.
Difesa informatica senza protezioni
Il capitolo più delicato riguarda la sicurezza. Google afferma che Argon è in grado di trovare, validare e correggere in autonomia molte vulnerabilità critiche. Ai difensori considerati affidabili e ai team interni sarà fornito senza le protezioni che limitano le richieste in ambito cyber. Se da un lato questo è un rischio, perché un modello che trova una falla per correggerla può trovarla anche per sfruttarla, dall’altro dovrebbe evitare situazioni paradossali come quelle che sono avvenute nel corso dell’incidente in cui un modello OpenAI ha attaccato Hugging Face durante un test, ma quando questa ha provato a usare GPT per analizzare l’attacco e difendersi, questo si è rifiutato per via dei guardrail di sicurezza.
Tra i primi utilizzatori c’è Wiz, società acquisita da Google la scorsa primavera. Wiz impiega Argon nell’iniziativa gratuita Scan for Good, dedicata alla protezione delle infrastrutture pubbliche critiche. Secondo Google, il modello ha individuato una vulnerabilità critica che esponeva dati personali sensibili in un software sanitario usato da ospedali in tutto il mondo. Su CWE-bench v1, dedicato alla correzione di vulnerabilità, Argon è primo in classifica a pari merito con il 68%.
Google ha dichiarato che prima del rilascio al pubblico rafforzerà le protezioni su quattro fronti:
- il rifiuto delle richieste utili ad attacchi informatici o con armi chimiche, biologiche, radiologiche e nucleari (CBRN), anche attraverso il monitoraggio delle attivazioni interne del modello;
- la resistenza alle prompt injection indirette, cioè istruzioni malevole nascoste nei contenuti che il modello elabora;
- la sorveglianza della catena di ragionamento, con l’interruzione dell’esecuzione quando il modello esce dai limiti;
- l’isolamento degli ambienti di test.
I risultati interni
Argon è già usato da migliaia di dipendenti Google, e l’azienda cita alcuni casi in cui Argon ha permesso di ottenere risultati notevoli:
- Nel calcolo quantistico, il modello ha migliorato del 40%, in pochi minuti, un risultato pubblicato nell’ottimizzazione delle risorse (qubit e porte logiche) di alcune subroutine.
- Sull’ottimizzazione della memoria, un gruppo di agenti Argon ha analizzato la telemetria di profilazione dei data center e applicato ottimizzazioni che hanno liberato oltre 300 TiB. Il risparmio complessivo stimato è compreso tra 500 TiB e 1 PiB.
- Sulle migrazioni di codice, gli agenti stanno portando codice C/C++ verso Rust, su progetti che arrivano alle oltre 800.000 righe del kernel Zircon di Fuchsia.
- Nel caso del decodificatore video libgav1, il risultato è 2,7 volte più veloce del precedente port in Rust e si avvicina alle prestazioni della versione C++ ottimizzata.


