Anthropic rilascia Claude Sonnet 5.5, più veloce ed economico di Opus ma con prestazioni agentiche simili
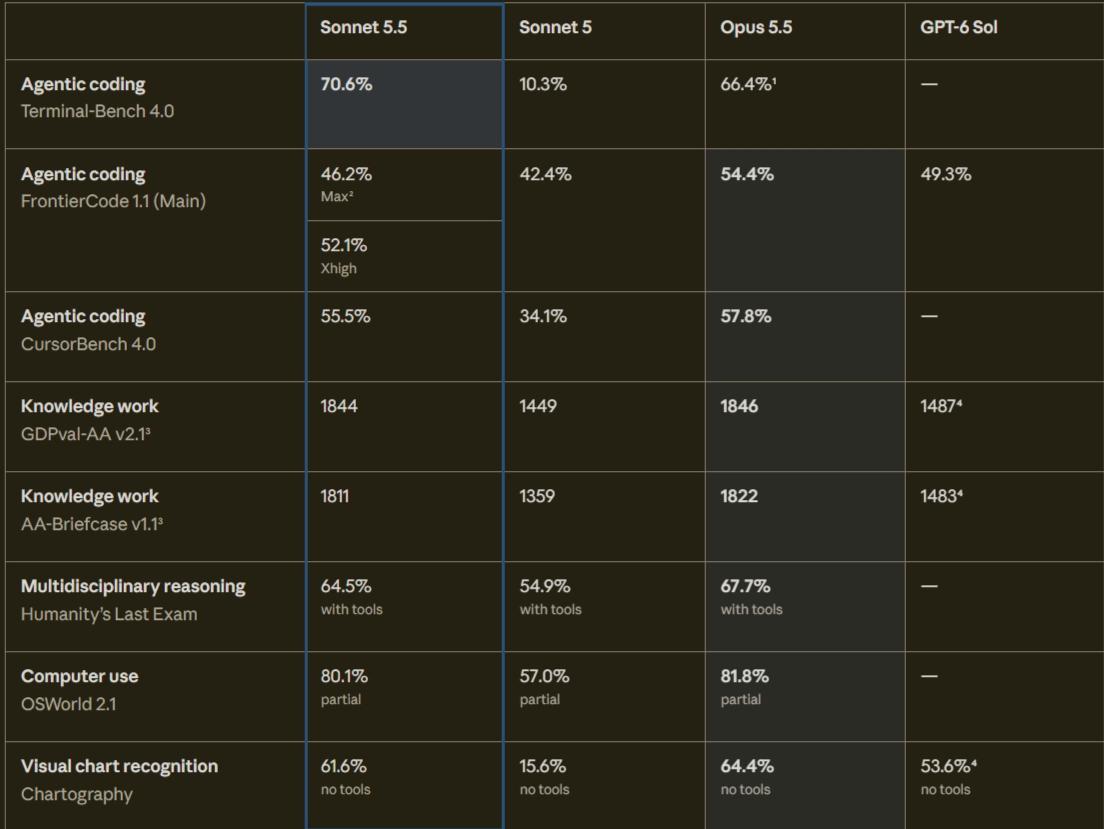
Il numero che vale l’intero lancio del nuovo modello di Anthropic sta in una riga della tabella dei benchmark. Su Terminal-Bench 4.0, test di coding agentico da riga di comando, Claude Sonnet 5.5 raggiunge il 70,6%, contro il 10,3% di Sonnet 5 e il 66,4% di Opus 5.5 al massimo livello di effort. Un modello di fascia media che supera l’ammiraglia di casa è una notizia, anche se va sempre ricordato che si tratta di cifre pubblicate da Anthropic.
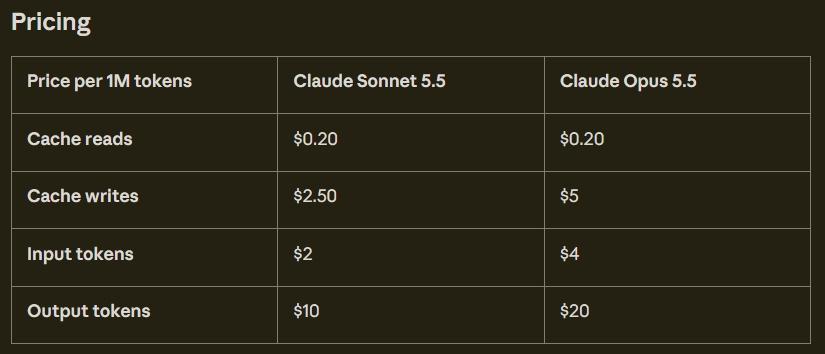
Claude Sonnet 5.5 è il secondo componente della famiglia 5.5 dopo Opus 5.5, uscito la settimana scorsa. Il listino prezzi prevede 2 dollari per milione di token in ingresso e 10 in uscita come per Sonnet 5, ma rispetto a Opus 5.5 è esattamente la metà. Sul fronte prestazioni Anthropic dichiara inoltre una generazione più rapida di oltre il 30% rispetto a Sonnet 5 e un costo per compito ridotto fino al 30%. Il vantaggio più solido del nuovo modello resta proprio quello economico.
Il risparmio effettivo dipende comunque da come si imposta il modello. Sonnet 5.5 espone cinque livelli di effort ricalibrati, da low a max, e la storia cambia parecchio a seconda di dove si mette la manopola. A livello medio (l’impostazione predefinita), il modello supera il miglior punteggio di coding di Sonnet 5 spendendo meno di un decimo. A livello alto, Sonnet 5.5 raggiunge GPT-6 Sol su FrontierCode con un costo per attività di circa un quinto. Chi punta al massimo sforzo, invece, paga in token quello che risparmia sul prezzo unitario.
E qui sta la parte che i comunicati tendono a sfumare. Artificial Analysis, che ha provato una build pre-release con un bug che secondo Anthropic avrebbe inciso poco, ha infatti misurato un consumo di token superiore a qualunque modello analizzato finora. Il prezzo per token, insomma, non coincide con il prezzo per compito, e chi gestisce pipeline agentiche lunghe farebbe bene a misurare sul proprio carico reale prima di rifare i conti. Un agente che macina milioni di token in cicli di ragionamento può infatti annullare buona parte del vantaggio di listino.
Al di fuori del terreno del codice, Anthropic cita 1.811 punti su AA-Briefcase v1.1 e il 61,6% su Chartography senza strumenti, benchmark che misurano lavoro d’ufficio e lettura di grafici. Il posizionamento dichiarato è quello di un modello per compiti ben circoscritti come correzione di bug e produzione di documenti, presentazioni e fogli di calcolo rifiniti, lasciando a Opus il lavoro che richiede giudizio ponderato.
C’è poi un cambio di regime sulla sicurezza. Anthropic sostiene infatti che le capacità di Sonnet 5.5 in ambito cybersecurity siano paragonabili a quelle di Opus 5 e per questo il modello nasce con gli stessi freni applicati finora solo ai sistemi più potenti, diventando così il primo Sonnet a essere lanciato con queste salvaguardie. Nella pratica, quando una richiesta viene giudicata ad alto rischio informatico, per esempio la scrittura di un exploit, il sistema la passa in modo visibile a Sonnet 5, un modello meno capace, invece di rifiutarla del tutto o di eseguirla con la piena potenza di 5.5.
Chi fa ricerca sulle vulnerabilità o penetration testing, si troverà quindi con risposte più deboli su certi task e conviene quindi provare i propri flussi prima di spostarli in produzione. Il modello adotta anche classificatori che impediscono l’estrazione del ragionamento, una difesa contro chi tenta di addestrare modelli concorrenti sulle sue risposte.
Per quanto riguarda infine la distribuzione, il modello, identificato da claude-sonnet-5-5 sulla Claude Platform, è disponibile su Amazon Web Services, Google Cloud e Microsoft Azure, con zero data retention. Per le aziende italiane ed europee la presenza sui tre grandi hyperscaler semplifica non poco procurement e conformità, perché si può restare nel perimetro contrattuale già in essere. Resta ora da vedere il terzo tassello della famiglia 5.5, visto che Anthropic ha già annunciato per le prossime settimane l’arrivo di Claude Haiku 5.5.


