Anche OpenAI introduce in Europa una filigrana invisibile nei testi di ChatGPT e Codex
Indice dell'articolo
OpenAI ha annunciato che, nelle prossime settimane, inserirà una filigrana invisibile nei testi prodotti da ChatGPT e Codex per gli utenti dell’Unione europea, su tutti i piani. Il sistema si chiama textGrain e secondo l’azienda risponde ai dettami dell’articolo 50 dell’AI Act, il regolamento europeo sull’intelligenza artificiale, che impone ai fornitori di rendere il testo generato identificabile in modo leggibile dalle macchine. L’annuncio arriva alcune settimane dopo quello di Anthropic, che ha introdotto una marcatura analoga per i testi di Claude.
Come funziona textGrain
textGrain non aggiunge caratteri nascosti né metadati, ma scrive un “segnale” inserendo delle alterazioni statistiche nelle scelte lessicali del modello: un rilevatore cerca poi quel segnale per stabilire se un brano contiene una filigrana di OpenAI. L’azienda ha pubblicato un rapporto tecnico, scritto con ricercatori dell’Università della Pennsylvania e di Yale, e prevede di rendere la tecnologia open source.
Secondo OpenAI, sui test condotti con Astra, il suo ultimo modello di punta, non emergono differenze significative di prestazioni tra testo con e senza filigrana. L’azienda sostiene inoltre che textGrain eguaglia o supera gli altri approcci provati, compreso SynthID per il testo di Google.
I limiti dichiarati dall’azienda
Il comunicato di OpenAI è insolitamente esplicito sui limiti del sistema. La premessa è che “la marcatura e il rilevamento del testo restano tecnologie ancora agli albori, con limiti significativi”. Qui alcuni dettagli sui principali limiti del sistema:
- La lunghezza conta. Con un tasso di falsi positivi dell’1% – cioè un testo non marcato scambiato per marcato una volta su cento – il rilevatore individua la filigrana in circa l’80% dei brani da 200 token (l’unità con cui i modelli scompongono il testo, grosso modo una parola o una sua parte) e in circa il 95% di quelli da 400 token. I dati si riferiscono a contenuti come la psicologia. Per argomenti con meno libertà di scelta lessicale, come la matematica, i tassi sono sensibilmente più bassi.
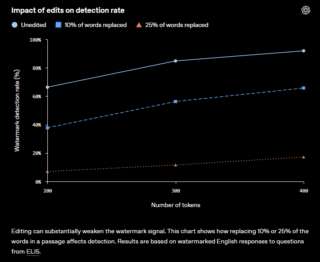
- Le modifiche indeboliscono il segnale. Su brani da 400 token, sostituire il 10% delle parole con sinonimi riduce il rilevamento da circa il 92% al 66%. Se le parole sostituite sono un quarto, scende al 17%.
- L’assenza di filigrana non prova nulla. Un testo senza segnale può essere troppo breve, modificato o tradotto. Può anche provenire da un modello non supportato o da strumenti di un altro fornitore.
OpenAI precisa anche ciò che la filigrana non dice: non misura il contributo umano, non stabilisce chi sia l’autore o il responsabile del testo, non identifica l’utente e ovviamente non è una garanzia dell’accuratezza del contenuto. Il comunicato non riporta risultati sul codice, pur includendo Codex nel perimetro, e non indica quali modelli siano considerati idonei.
Il rilevatore resta riservato, e il paradosso di fondo
Per questi limiti OpenAI non renderà pubblico il rilevatore. Da oggi ricercatori e organizzazioni esperte possono presentare domanda di accesso, che sarà concesso caso per caso, in linea con il Codice di condotta dell’Unione europea sui contenuti generati dall’intelligenza artificiale. Lo strumento indicherà soltanto se rileva una filigrana di OpenAI, senza identificare l’utente né rivelare prompt o conversazioni. Restano invece pubblici gli strumenti di verifica per immagini e audio.
C’è però un aspetto paradossale nell’implementazione di textGrain: almeno inizialmente, la filigrana sarà aggiunta soltanto ai contenuti generati da utenti all’interno dell’Unione Europea. Fuori dall’Europa, ChatGPT e Codex non avranno la filigrana per impostazione predefinita. Se l’intento è quello di tutelare il fruitore del contenuto, permettendogli di verificare – anche se indirettamente – se il contenuto è stato generato dall’AI, l’approccio adottato offre una tutela molto parziale. Anthropic, invece, marca i testi di Claude dal 2 agosto in tutto il mondo, non solo in Europa, con una variante del metodo SynthID-Text sviluppato da Google DeepMind, come riportato da The Next Web.
Gli sviluppatori che usano le API possono attivarla, in tutto il mondo e su base volontaria, per alcuni modelli. OpenAI sta lavorando con i partner cloud per offrire textGrain anche tramite i loro servizi nelle prossime settimane.
Che cosa cambia per le aziende
Per le imprese italiane che producono contenuti con ChatGPT – testi di marketing, documentazione, codice – la filigrana renderà i testi potenzialmente riconoscibili come generati con l’intelligenza artificiale. Un sistema che quindi permetterebbe di verificare se l’azienda è stata conforme all’AI Act, che richiede di rivelare l’origine artificiale del testo, se riguarda un argomento di pubblico interesse e non è stato sottoposto a ulteriore controllo editoriale.
Il condizionale però è d’obbligo: oggi il rilevatore è accessibile solo a soggetti approvati e, come mostrano i test di OpenAI, una riscrittura anche parziale può far scendere il tasso di rilevamento sotto il 20%. Un testo breve o molto rivisto può quindi risultare pulito pur avendo un’origine artificiale.
La conseguenza pratica riguarda soprattutto le regole interne. Conviene verificare quali policy regolano l’uso di contenuti generati dall’intelligenza artificiale e la loro divulgazione, anziché affidarsi all’idea che la filigrana, in un senso o nell’altro, faccia da prova.
(Immagine di apertura generata con AI)


