Maia 300 è il chip per l’inferenza AI che Microsoft userà dal 2027 su scala “multi-gigawatt”
Indice dell'articolo
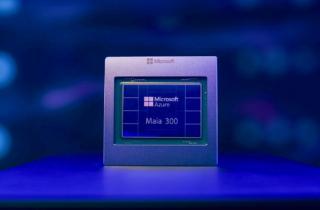
Microsoft ha presentato Maia 300, la terza generazione dei propri acceleratori per l’inferenza AI, cioè la fase in cui un modello già addestrato risponde alle richieste e genera testo, codice o altri contenuti. A partire dal 2027 l’azienda prevede di installarlo nei data center di Azure su scala multi-gigawatt, facendone “il principale sistema di inferenza AI per i prodotti e i servizi Microsoft”.
L’annuncio arriva a meno di dieci mesi dalla presentazione di Maia 200, avvenuta il 26 gennaio. Secondo Microsoft, il nuovo chip genererà il 40% di token in più per megawatt assorbito rispetto ai “principali sistemi basati su GPU” (leggasi: la piattaforma NVIDIA) e, in un rack completo da 96 acceleratori, fino a sette volte i token elaborati da un rack Maia 200.
La precedente incarnazione, Maia 200 era prodotta da TSMC a 3 nanometri con 216 GB di memoria HBM3e e un consumo di 750 W, prometteva al lancio prestazioni per dollaro superiori del 30% rispetto all’hardware più recente dell’infrastruttura Microsoft.
Il comunicato di oggi afferma che Maia 200 è in fase di installazione negli Stati Uniti, in Europa e in Australia, e che offre fino a 1,7 volte più token per watt per le funzioni AI di Teams e Copilot. Afine luglio, secondo The Information, i chip Maia erano attivi soltanto in due data center statunitensi, e Maia 200 avrebbe mancato alcuni obiettivi interni nei primi test, ritardando il lancio.
Cosa cambia nell’architettura
Il blog post tecnico di Rani Borkar, Presidente di Azure Hardware Systems and Infrastructure, e Saurabh Dighe, Corporate Vice President, Systems Planning and Architecture, descrive un chip pensato per contesti molto lunghi, ragionamento e agenti che lavorano in più passaggi. In questi scenari il modello deve mantenere in memoria grandi quantità di dati intermedi tra un passaggio e l’altro.
- Architettura a chiplet. Il chip è suddiviso in più componenti nello stesso involucro: la logica di calcolo è prodotta con il processo TSMC N2P, a 2 nanometri, mentre memoria e input/output sono gestiti da chip separati. Microsoft dichiara il 36% di capacità di calcolo in più e il 14% di banda in più per le comunicazioni tra acceleratori rispetto a Maia 200.
- Più memoria, organizzata in modo diverso. Ogni acceleratore dispone di otto moduli di memoria HBM4 (High Bandwidth Memory, memoria ad alta larghezza di banda impilata accanto al processore), per un totale di 288 GB e 18 TB/s (+33% di capacità e 2,5 volte la banda di Maia 200). La memoria passa inoltre a un’organizzazione NUMA (Non-Uniform Memory Access): ogni area di calcolo ha una porzione di memoria più vicina e il software colloca i dati accanto alle unità che li usano, riducendo l’energia spesa per spostarli.
- Precisione ridotta. Il chip introduce una versione migliorata di MXFP4, un formato che rappresenta i numeri con 4 bit invece dei consueti 8 o 16, e formati di memorizzazione sotto i 3 bit. Meno bit significano meno dati da trasferire, ma l’impatto sulla qualità delle risposte dipende dal modello.
Un rack da 96 acceleratori e superpod da oltre 12.000
Il rack Maia 300 raddoppia la densità rispetto alla generazione precedente: 96 acceleratori distribuiti su 24 server da quattro, ciascuno con il proprio processore di controllo, in un rack da 167 kW. Più dell’80% del calore viene rimosso con raffreddamento a liquido. Il sistema può collegarsi direttamente al circuito idraulico (direct to chip) oppure usare uno scambiatore di calore per funzionare in data center raffreddati ad aria, ampliando le strutture in cui può essere installato.
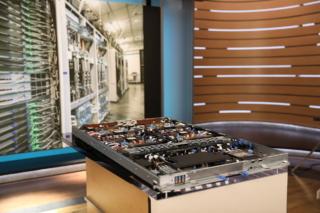
Un server con Maia 300 e, sullo sfondo, dei rack che ospitano ciascuno 24 server
La rete è basata su Ethernet, con un protocollo di trasporto sviluppato da Microsoft. All’interno del rack i collegamenti sono elettrici, mentre un secondo livello di switch ottici unisce fino a 128 rack in un “superpod” da 12.288 acceleratori, in cui ogni acceleratore può scambiare dati con qualsiasi altro fino a 750 GB/s.
Questa struttura permette, tra l’altro, di separare le due fasi dell’inferenza – la lettura della richiesta (prefill) e la generazione della risposta (decode) – su gruppi diversi di chip. Tra i due gruppi è condivisa la cache KV, la memoria di lavoro in cui il modello conserva il contesto della conversazione.
A chi serve e chi potrà usarlo
Maia 300 nasce per i servizi interni di Microsoft. Il comunicato cita gli agenti di programmazione di GitHub, i modelli erogati tramite Microsoft Foundry, il team AI interno e Dragon Copilot, l’assistente per la documentazione clinica. Non c’è invece alcuna indicazione sulla disponibilità di istanze Maia per i clienti Azure.
Per CIO e responsabili IT l’effetto sarà quindi indiretto. Se le stime di efficienza reggeranno, potrebbero tradursi in costi inferiori per Copilot e per i modelli erogati su Foundry. Secondo The Information, l’azienda ha discusso con Anthropic l’utilizzo dei chip Maia, ma finora nessun accordo è stato annunciato.
La corsa degli hyperscaler al silicio proprietario
Con Maia 300 Microsoft cerca di recuperare terreno su Google e Amazon, che con TPU e la coppia Trainium/Inferentia servono già grandi clienti esterni. La distanza è soprattutto in termini di volumi. Ad agosto The Information ha riferito che Microsoft stava trattando con TSMC una capacità produttiva di oltre 300.000 Maia 300 per il 2027, contro le decine di migliaia di Maia 200 prodotte fino a quel momento. Morgan Stanley stima che Google possa produrre più di 3 milioni di TPU quest’anno e fino a 5 milioni il prossimo.
L’obiettivo annunciato oggi – un’infrastruttura multi-gigawatt a partire dal 2027 – indica che Microsoft intende spostare su Maia una quota crescente dei propri carichi di inferenza, riducendo la dipendenza dalle GPU Nvidia. I tempi dipenderanno dalla capacità di TSMC, dalla disponibilità di memorie HBM4 e dalla maturità del software. Ulteriori dettagli sono attesi a Microsoft Ignite, in programma a San Francisco dal 17 al 20 novembre.


