Le TPU Google di ottava generazione ottimizzano i carichi per inferenza riservata e contesti lunghi
Indice dell'articolo
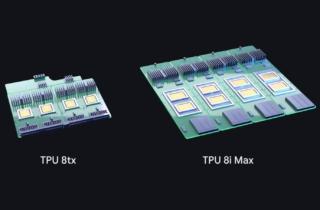
Google ha ampliato la famiglia di TPU (Tensor Processing Unit, gli acceleratori per l’intelligenza artificiale progettati internamente) di ottava generazione con due nuovi sistemi. TPU 8tx è pensata per eseguire modelli e agenti AI su dati sensibili, che restano protetti anche mentre vengono elaborati. TPU 8i Max combina due chip TPU 8i in un unico package per gestire finestre di contesto molto ampie con la massima densità di calcolo per rack. Insieme a TPU 8t e TPU 8i, presentate ad aprile, la generazione conta ora quattro configurazioni: è la prima volta che Google ne annuncia tante nello stesso anno.
Il dettaglio da non perdere è che non si tratta di nuovi chip, ma di nuovi sistemi. Lo sottolinea lo stesso Amin Vahdat, Senior Vice President e Chief Technologist per AI e infrastruttura di Google, nel post che accompagna l’annuncio. TPU 8tx usa lo stesso silicio di TPU 8t, TPU 8i Max raddoppia quello di TPU 8i. A cambiare sono il package, la memoria, la rete, il processore host e la sicurezza che circondano il chip. Secondo Google, questo approccio modulare permette di rilasciare configurazioni specializzate in pochi mesi anziché negli anni richiesti dalla progettazione e messa in produzione di un nuovo processore.
TPU 8tx porta il confidential computing sulle TPU
Di norma i dati sono cifrati quando vengono archiviati o trasmessi in rete, ma devono essere decifrati in memoria per essere elaborati. Il confidential computing – la protezione hardware dei dati anche durante l’uso – chiude anche questa finestra. TPU 8tx integra questa protezione a livello hardware e mantiene isolati sia i dati sensibili sia i pesi del modello, cioè i parametri che ne costituiscono il valore. È la prima TPU di Google con questa funzione.
Il sistema è abbinato a processori host AMD EPYC di quinta generazione e adotta Boardfly, la rete a bassa latenza sviluppata per TPU 8i. Google dichiara una latenza fino a due volte inferiore rispetto a TPU 8t, con una penalizzazione delle prestazioni che definisce quasi nulla. Il pubblico di riferimento sono le aziende dei settori regolamentati e le amministrazioni pubbliche che vogliono usare modelli proprietari o di frontiera sui propri dati più riservati.
Oltre all’inferenza, TPU 8tx è proposta anche per l’addestramento su piccola scala. Le aziende possono così specializzare un modello sui propri dati (fine-tuning), distillare un modello grande in uno più piccolo e addestrare agenti con l’apprendimento per rinforzo nello stesso sistema, senza spostare dati sensibili tra cluster separati.
Va detto che il confidential computing sugli acceleratori AI non è una novità di mercato: Nvidia lo offre sulle proprie GPU dall’architettura Hopper. Con TPU 8tx Google colma quindi un divario più che aprire una strada. Il post non fornisce dettagli su attestazione remota, certificazioni di sicurezza o integrazione con gli altri servizi di confidential computing di Google Cloud.
TPU 8i Max contro il muro della memoria
TPU 8i Max affronta un altro problema, il cosiddetto memory wall: la capacità di calcolo dei processori cresce più in fretta della capacità della memoria di fornire loro i dati. Il collo di bottiglia diventa evidente quando decine di agenti lavorano insieme su un intero codice sorgente o su ore di video.
La soluzione di Google è affiancare due chip TPU 8i nello stesso package. Rispetto a TPU 8i, il sistema raddoppia la potenza di calcolo, la SRAM – la memoria ultraveloce integrata nel chip, che in TPU 8i è di 384 MB – e la larghezza di banda della HBM, la memoria ad alta banda montata accanto al processore. Poiché TPU 8i Max occupa lo stesso spazio nel rack con il doppio del silicio, i data center ottengono più potenza di calcolo per metro quadro e per watt. Google non indica però consumi per rack né requisiti di raffreddamento specifici: un aspetto non secondario, dato che le TPU di ottava generazione richiedono già il raffreddamento a liquido.
Il software: PyTorch, agenti e TPU Sync
Il limite storico delle TPU non è mai stato l’hardware, ma l’ecosistema software, dominato dalle GPU Nvidia e dal loro ambiente di sviluppo CUDA. Su questo fronte Google ha accompagnato l’annuncio con diverse novità:
- TorchTPU, reso open source il mese scorso, permette di eseguire nativamente sulle TPU codice PyTorch e modelli Hugging Face, con backend pronti per i motori di inferenza open source vLLM e SGLang.
- Suite di agenti per TPU, open source e in anteprima, si integra con strumenti/harness di sviluppo come Claude Code, Cursor e Google Antigravity. Promette di automatizzare l’adozione delle TPU, individuare i colli di bottiglia e ottimizzare i kernel personalizzati con istruzioni in linguaggio naturale.
- TPU Sync, reso open source, unifica memoria HBM, DRAM dei server host, storage condiviso e rete in un’unica gerarchia di memoria. Gestisce in particolare la cache KV, la memoria in cui il modello conserva i calcoli sui token già elaborati per non doverli ripetere. Google dichiara una riduzione di oltre il 90% della latenza di trasferimento della cache KV e del TTFT (Time to First Token, il tempo necessario a generare il primo token della risposta), senza specificare le condizioni di misura.
- Agent Compute Engine sospende le sessioni degli agenti inattivi, per esempio in attesa di una risposta da un database o da una persona, e sposta la loro memoria di lavoro fuori dal chip per ridurre i costi.
- Cloud Pathways, il sistema con cui Google DeepMind orchestra l’addestramento di Gemini, è ora disponibile su Google Kubernetes Engine. Diventa disponibile anche il dynamic slicing di GKE, che ricompone le topologie di TPU al volo: secondo Google l’avvio dei lavori è fino a 5 volte più rapido e il ripristino dai guasti fino a 4,5 volte più veloce.
Google cita inoltre i risultati dei benchmark InferenceX e AgentX della società di analisi SemiAnalysis, che premierebbero le TPU per rapporto prezzo/prestazioni su carichi di lavoro agentici e a contesto lungo.
Disponibilità e contesto di mercato
Google non ha comunicato date di disponibilità, regioni cloud né prezzi per TPU 8tx e TPU 8i Max. Anche TPU 8t e TPU 8i, annunciate ad aprile con disponibilità prevista entro la fine del 2026, non hanno ancora un calendario di disponibilità dettagliato. Per i clienti europei interessati a TPU 8tx, la presenza nelle region continentali sarà un elemento decisivo, ma il comunicato non ne fa cenno.
Secondo Google, le TPU sono ormai un business in rapida crescita con quasi 100 clienti, tra laboratori di AI, società di trading, retailer e università, alcuni dei quali le installano direttamente nei propri data center. L’azienda resta comunque anche un grande cliente di Nvidia, di cui offre le GPU più recenti su Google Cloud. La partita delle TPU si gioca quindi su due fronti: dimostrare che l’hardware specializzato conviene sul piano dei costi e rendere il passaggio dalle GPU abbastanza semplice da non richiedere la riscrittura del codice. Per molte aziende la seconda novità – il supporto nativo a PyTorch – potrebbe pesare più dei nuovi sistemi.


