L’IA si sta mangiando anche i supercomputer. Nuovi ingressi nella Top500 ai minimi storici
Alla conferenza SC26 di Chicago è stata pubblicata la 68ª lista TOP500, la classifica semestrale dei supercomputer più potenti al mondo. Le prime dieci posizioni sono identiche a quelle di giugno. In testa resta il cinese LineShine con 2,198 exaflop, seguito da quattro sistemi oltre la soglia dell’exaflop. L’Italia è presente nella top 10 con due sistemi di Eni: HPC7 al sesto posto e HPC6 all’ottavo. I nuovi ingressi in classifica sono appena 27, il minimo nella storia della lista. Nella stessa settimana, Nvidia ha annunciato Rubin HPC, una GPU dedicata a simulazione ed elaborazione dati, attesa nel 2028.
La Top 10 e i cinque sistemi exascale
LineShine è installato al National Supercomputing Centre di Shenzhen. È un sistema basato solo su CPU: usa la piattaforma LingKun con processori LX2 a 304 core a 1,55 GHz, per un totale di 13.789.440 core, e un’interconnessione proprietaria chiamata LingQi. Le prestazioni misurate con il benchmark HPL (High Performance Linpack, il test di calcolo su matrici dense usato per stilare la classifica) sono pari a 2.198 petaflop. LineShine guida anche la classifica HPCG, un benchmark che simula carichi applicativi più realistici, con 22 petaflop.
Al secondo posto c’è El Capitan del Lawrence Livermore National Laboratory (1.809 petaflop), seguito da Frontier di Oak Ridge (1.353) e Aurora di Argonne (1.012). Il quinto posto è del tedesco JUPITER Booster, installato a Jülich nell’ambito di EuroHPC, che raggiunge esattamente 1 exaflop e resta l’unico sistema exascale europeo.
Completano la Top 10 Eagle di Microsoft Azure al settimo posto (561,2 petaflop), il giapponese Fugaku di RIKEN al nono (442,01) e lo svizzero Alps del CSCS al decimo (434,9). Sei dei primi dieci sistemi usano l’interconnessione Slingshot-11 di HPE.
Eni, l’unica azienda con due sistemi nella Top 10
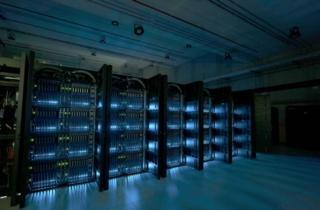
HPC7 di ENI (nella foto di apertura) raggiunge 571,5 petaflop misurati su un picco teorico di 861,13. Si basa su piattaforma HPE Cray EX255a con processori AMD EPYC di quarta generazione e acceleratori AMD Instinct MI300A, la stessa architettura di El Capitan. HPC6, installato nel Green Data Center di Ferrera Erbognone, in provincia di Pavia, si ferma a 477,9 petaflop e usa invece la generazione precedente, HPE Cray EX235a con acceleratori AMD Instinct MI250X, come Frontier.
Con due sistemi davanti a Fugaku e Alps, Eni conferma un caso raro nella parte alta della classifica: un’infrastruttura di calcolo aziendale, usata per la ricerca energetica e la modellazione geofisica, che compete per potenza con i grandi centri di ricerca pubblici. Eagle di Microsoft è l’unico altro sistema aziendale nella Top 10.
I primi 10 supercomputer italiani nella classifica Top500
Perché i nuovi ingressi sono così pochi
Il dato più significativo di questa edizione è il calo del ricambio: 27 nuovi sistemi, il numero più basso mai registrato. La soglia d’ingresso è comunque salita del 7,3% rispetto a giugno, a 2,857 petaflop, e le prestazioni complessive dei 500 sistemi crescono del 4,4% a 19,57 exaflop. Gli acceleratori sono presenti in 291 sistemi, il 58,2% del totale.
Gli organizzatori della classifica attribuiscono il rallentamento allo spostamento degli investimenti verso grandi cluster per l’intelligenza artificiale, che in genere non vengono sottoposti al benchmark HPL e quindi restano fuori dalla lista. Secondo gli organizzatori, la crescita si è spostata verso le AI factory e dai sistemi pensati per la massima potenza di picco a quelli pensati per la capacità complessiva. Una stima di Epoch AI indica che, alla fine del 2025, cinque hyperscaler statunitensi detenevano il 71% della capacità di calcolo per l’AI a livello globale. Il TOP500, in altre parole, misura una parte sempre più piccola della potenza di calcolo effettivamente installata.
Sul fronte dell’efficienza energetica, la classifica Green500 resta guidata dal francese KAIROS con 73,28 gigaflop per watt, davanti a ROMEO-2025 (70,91) e all’estensione GPU del tedesco Levante (69,43).
Nvidia Rubin HPC, la GPU per la simulazione scientifica
Alla stessa conferenza, Nvidia ha presentato Rubin HPC, una nuova GPU della piattaforma Vera Rubin pensata per simulazioni ed elaborazione dati in ambito scientifico, ingegneristico e analitico. Il chip avrà oltre 50.000 core CUDA, il numero più alto mai dichiarato da Nvidia per una singola GPU. La GPU Rubin attuale ne ha 28.672, distribuiti su 224 streaming multiprocessor: l’incremento è quindi di almeno il 75%.
Le GPU comunicheranno tra loro attraverso NVLink di settima generazione, l’interconnessione proprietaria di Nvidia. L’azienda parla di un’architettura che bilancia calcolo e movimento dei dati, con funzioni di accelerazione per i dati sparsi. Gli ambiti indicati sono modelli climatici, simulazioni ingegneristiche, analisi genomica e rischio finanziario, con operazioni come calcoli su matrici sparse, calcoli stencil, ordinamenti e riduzioni.
Nella comunicazione di Nvidia l’accento cade sugli agenti AI che usano le librerie CUDA-X per lanciare simulazioni e analisi. Per Ian Buck, Vice President Hyperscale and High-Performance Computing di Nvidia, “per gli agenti che affrontano problemi scientifici e ingegneristici, una simulazione più veloce significa scoperte più rapide”.
Cosa significa per chi pianifica infrastrutture di calcolo
Rubin HPC arriverà nel 2028 e non ha ancora specifiche complete, ma indica la direzione del piano di sviluppo di Nvidia oltre l’AI generativa: un ritorno esplicito alla simulazione, letta però attraverso il filtro degli agenti AI. Per chi valuta investimenti in calcolo ad alte prestazioni, la variabile decisiva resterà il rapporto tra prestazioni in doppia precisione e in bassa precisione, terreno su cui AMD – fornitore degli acceleratori di El Capitan, Frontier e dei due sistemi Eni – ha costruito la propria posizione nella parte alta della classifica.


