Gemini 4 Carbon è il nuovo modello Google che trova e ripara le vulnerabilità del software
Indice dell'articolo
Il 28 ottobre Google ha presentato Gemini 4 Carbon, il modello più potente della famiglia Gemini, progettato per la sicurezza informatica e per i compiti di sviluppo software che possono durare anche diversi giorni. Carbon individua le vulnerabilità nel codice, verifica se sono sfruttabili e ne corregge la causa. Per ora è accessibile solo a un gruppo ristretto di aziende di sicurezza cyber attraverso il programma Fairwind. Google non ha indicato una data per sviluppatori, aziende e altre categorie di utenti.
L’annuncio è nel post sul blog di Google firmato da Koray Kavukcuoglu, SVP di Google DeepMind e Chief AI Architect di Google. Il modello arriva due settimane dopo Gemini 4 Argon, di cui condivide l’architettura di sicurezza.
Dalla scoperta della falla alla correzione
Google descrive tre fasi del ciclo di difesa e ha testato ciascuna di esse con un benchmark. SEC-bench Pro misura la capacità di trovare vulnerabilità in software reale: Carbon ottiene l’88,2%. ExploitGym valuta se una falla può essere effettivamente sfruttata, un dato utile per decidere quali correggere per prime: qui il risultato è il 54,8%. CWE-bench misura la capacità di riparazione. Il nome richiama CWE (Common Weakness Enumeration), il catalogo standard delle categorie di debolezza del software. Carbon raggiunge il 71,0%.
Google precisa che questi test esterni sono stati eseguiti senza salvaguardie attive. Le versioni destinate ai partner potrebbero quindi comportarsi in modo diverso. Uno dei principali problemi nell’utilizzo di modelli AI a scopo difensivo, è che spesso i guardrail di sicurezza impostati dai produttori per impedire che gli LLM vengano usati da cyber criminali a scopo di attacco, intervengono anche quando si cerca di usarli per lo scopo opposto: correggere le vulnerabilità e difendersi da un attacco. Lo sanno bene in Hugging Face, dove questo problema si è manifestato quando hanno cercato di difendersi da un attacco orchestrato da un agente sperimentale di OpenAI fuggito dalla sandbox di test.
A questi numeri si aggiungono misure interne, non accompagnate da dati pubblici. Secondo Google, nella generazione di codice sicuro Carbon ha un tasso di successo più che raddoppiato rispetto ad Argon. Stiamo parlando di un modello rilasciato non due anni o due mesi fa, ma due settimane. Il team di Chrome lo avrebbe trovato oltre dieci volte migliore di un altro modello di frontiera, non nominato nel post, nel produrre patch di qualità. Wiz, piattaforma di sicurezza cloud controllata da Google, lo vede in testa nei propri test di penetrazione web.
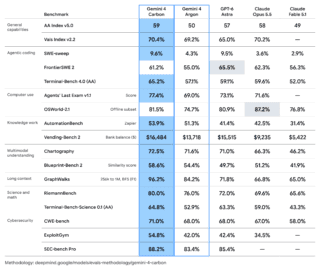
I dati dei benchmark pubblicati da Google nel suo post di lancio.
Sul fronte dello sviluppo software, Google afferma che i suoi team hanno visto Carbon lavorare per giorni su bug molto piccoli in grandi basi di codice e in sistemi a basso livello. Non fornisce però un tasso di completamento di questi compiti.
Cosa dicono davvero i numeri
Quasi tutti i dati arrivano da Google. Winbuzzer, che ha analizzato il lancio, ricorda che nella misura a singolo tentativo di CWE-bench il 71% di Carbon supera di tre punti Argon, GPT-6 Astra e Grok 4.7, tutti al 68%, e di quattro Claude Opus 5.5, al 67%. Il confronto riguarda sistemi completi, perché ogni modello è stato valutato nell’ambiente di programmazione del proprio sviluppatore. Con quattro tentativi per compito, inoltre, la classifica pubblicata vede in testa Grok 4.7 all’81% e Opus 5.5 al 79%, mentre per Carbon non abbiamo ancora un risultato. Resta infine un margine di errore: con un solo tentativo, il modello sbaglia quasi tre volte su dieci.
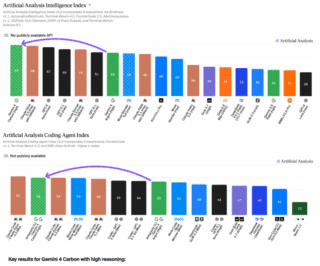
Google indica Carbon al primo posto nell’indice Artificial Analysis Intelligence Index v5.0, con 59 punti. Opus 5.5 di Anthropic è a 58. Lo stesso valutatore misura per Carbon un tasso di allucinazione dell’11% in un test di conoscenza fattuale, contro il 4% di Argon, anche se il modello risponde correttamente a più domande.
Accesso riservato ai difensori
Google motiva l’apertura graduale con il possibile doppio uso della tecnologia: capacità che aiutano a trovare e correggere le falle possono servire anche a chi attacca. Il progetto Fairwind, lanciato a settembre con Gemini 3.8 Flash Cyber, è aperto a governi e autorità nazionali di cybersicurezza, a gestori di infrastrutture critiche (sanità, telecomunicazioni, energia, finanza) e a piattaforme tecnologiche di base. Al lancio Google parlava di oltre 650 partner nel mondo.
I partecipanti vengono sottoposti a verifiche preliminari e devono adottare un’autenticazione a più fattori resistente al phishing, cioè non aggirabile con pagine contraffatte che intercettano i codici. L’accesso è limitato ai team interni di sicurezza, risposta agli incidenti o test di penetrazione. Ai partecipanti è vietato condividere o rivendere l’uso del modello.
Google partecipa inoltre al processo volontario del governo statunitense per i test prima del rilascio e raccoglie feedback sulle salvaguardie prima di aprire il modello al pubblico. Nel caso di Argon, secondo Winbuzzer, l’annuncio ai soli partner Fairwind è del 30 settembre e l’apertura agli sviluppatori è arrivata il 13 ottobre.
Prezzi e implicazioni per le aziende
Carbon debutta alle stesse tariffe introduttive di Argon: 2 dollari per milione di token in ingresso e 10 dollari per milione in uscita. I token in ingresso già elaborati, riutilizzati dalla cache, costano il 95% in meno. Finito il periodo introduttivo, di cui Google non indica la scadenza, i prezzi salgono a 4 e 20 dollari.
Anche se la maggior parte delle aziende non potrà sfruttare Carbon in tempi brevi, il lancio indica però una direzione: scoperta e sfruttamento automatici delle vulnerabilità stanno accelerando, e un modello che riesce a sfruttare più della metà dei casi di ExploitGym rende meno remota l’idea di attacchi condotti con strumenti analoghi.