AWS porta il codice PyTorch sui chip Trainium senza riscritture e sfida il vantaggio software di Nvidia CUDA
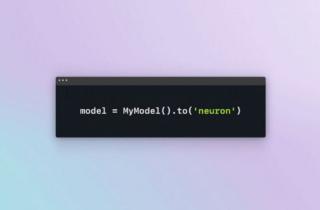
Amazon Web Services (AWS) ha annunciato TorchNeuron, un software che permette di eseguire sui chip proprietari Trainium il codice scritto con PyTorch, il framework open source con cui viene sviluppata la maggior parte dei modelli di intelligenza artificiale. Secondo Amazon basta cambiare un’impostazione di configurazione, senza riscrivere il codice. Dopo una fase di beta privata iniziata alla fine del 2025, il software è disponibile in beta pubblica e viene rilasciato oggi come open source con licenza Apache 2.0, in concomitanza con la PyTorch Conference North America di San Jose, in California.
CUDA nel mirino
Secondo Amazon, l’85% di ricercatori e sviluppatori di AI scrive il proprio codice in PyTorch. Il framework, nato in Facebook e dal 2022 affidato alla Linux Foundation, è in teoria indipendente dall’hardware. Nella pratica, però, Nvidia ha investito per quasi vent’anni in CUDA, lo strato software che collega i framework alle sue GPU, e nelle librerie costruite sopra di esso. Il risultato è che oggi PyTorch funziona al meglio su hardware Nvidia quasi per impostazione predefinita.
Spostare un carico di lavoro su chip diversi significa di solito settimane o mesi di adattamento e nuova validazione del codice. È questo costo di migrazione, più del prezzo del silicio, a tenere molte aziende legate a Nvidia. TorchNeuron è quindi il colpo più diretto finora sferrato da Amazon al vantaggio software del concorrente Nvidia.
Come funziona TorchNeuron
TorchNeuron sostituisce la precedente integrazione tra PyTorch e Neuron, il kit di sviluppo dei chip Trainium. Quella integrazione passava per XLA, un compilatore che trasforma il codice in un grafo di operazioni prima di eseguirlo: un approccio che rendeva complicato il debug e rompeva la compatibilità con parte dell’ecosistema PyTorch.
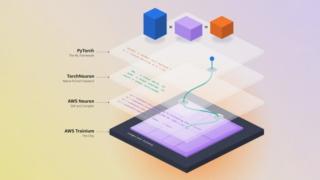
Il nuovo backend si aggancia invece al meccanismo standard con cui PyTorch registra un nuovo tipo di hardware. Ne derivano due conseguenze pratiche:
- la prima è il supporto all’esecuzione in modalità eager, in cui le operazioni vengono eseguite una alla volta e i dati intermedi possono essere ispezionati come su una GPU;
- la seconda è che gli strumenti già usati per test, debug e scalabilità funzionano senza modifiche, compreso torch.compile per l’ottimizzazione in produzione.
Il software supporta Trainium2 e Trainium3 e si integra con TorchTitan, il framework nativo di PyTorch per l’addestramento distribuito. Supporta FSDP (Fully Sharded Data Parallel), la tecnica che suddivide parametri e stato di un modello di grandi dimensioni tra più acceleratori. Hugging Face ha abilitato il supporto nativo a Trainium nei propri strumenti di sviluppo, senza codice specifico per Amazon. AWS dichiara inoltre di aver contribuito a vLLM, un motore open source per velocizzare l’inferenza, e di aver pubblicato come open source la propria libreria di kernel, le routine di calcolo a basso livello ottimizzate per i chip.
Sul fronte della qualità, Amazon afferma di testare TorchNeuron a ogni build su centinaia di migliaia di modelli. Secondo GeekWire, i test notturni coinvolgono oltre 100.000 modelli presi da Hugging Face.
L’argomento economico di AWS
In un’email a TechCrunch, Colin Brace, Vice President of Technology Software di AWS Annapurna Labs, la divisione che progetta i chip proprietari di Amazon, ha sostenuto che il valore di Trainium sta nel rapporto prezzo/prestazioni e nella possibilità di usare la stessa piattaforma sia per l’addestramento sia per l’inferenza. Brace ha contrapposto l’offerta di AWS a quella dei cosiddetti neocloud, i fornitori specializzati nel calcolo per l’AI come CoreWeave e Nebius, in gran parte basati su hardware Nvidia.
Come esempio, Brace ha citato Deepgram, fornitore di servizi di AI vocale. Dopo il passaggio a Trainium, l’azienda elaborerebbe il 70% di audio in più per ogni dollaro speso, a parità di accuratezza. Secondo quanto riportato da Reuters, Amazon conta oltre 30 clienti nella fase di beta, in settori che vanno dalla robotica ai modelli del mondo fisico (world model) fino all’AI vocale. Il comunicato cita la startup Cartesia e il Lieber Institute for Brain Development, che usa modelli di AI nella ricerca di nuovi farmaci.
I limiti da tenere presenti
AWS non è la prima a percorrere questa strada. Il codice PyTorch può già essere spostato anche sulle GPU di AMD o sui chip di Apple con una semplice modifica di configurazione, e anche Google sta sviluppando un progetto analogo per le proprie TPU, chiamato TorchTPU.
La portabilità, inoltre, riguarda solo ciò che è scritto in PyTorch. Le architetture che includono codice CUDA personalizzato, come kernel scritti a mano per ottimizzare le prestazioni, non si spostano con un cambio di impostazione. Il software, infine, è ancora in beta, e le affermazioni sulla facilità di migrazione dovranno essere messe alla prova in casi reali.
Per le aziende italiane che addestrano o servono modelli su AWS, la novità non impone scelte immediate. Offre però un’opzione concreta: anche spostare solo una parte dei carichi di lavoro può rafforzare la posizione negoziale nei confronti dei fornitori di capacità GPU. La verifica, come sempre, andrà fatta su carichi rappresentativi, confrontando prestazioni, costo complessivo e disponibilità delle istanze nelle region di interesse. Il banco di prova vero non saranno i grandi clienti già legati ad Amazon come Anthropic, ma le aziende di medie dimensioni che dovranno decidere se il costo del passaggio è ormai abbastanza basso da tentare la migrazione.