Ecco i primi PC con AMD Gorgon Halo per l’AI, ma i 192 GB di RAM unificata si pagano cari
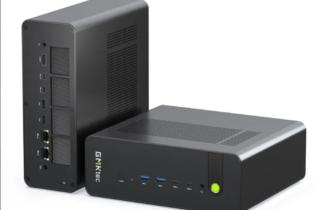
Nella corsa all’intelligenza artificiale locale, la quantità di memoria disponibile conta quasi quanto la potenza del processore. A dimostrarlo è il nuovo GMKtec EVO-X5 Pro, uno dei primi sistemi basati sulla piattaforma AMD Gorgon Halo e dotato di ben 192 GB di memoria unificata LPDDR5X-8533. Il produttore ha inizialmente progettato la macchina per gestire localmente modelli da 300 miliardi di parametri, ma con le ultime ottimizzazioni dichiara di essere arrivato fino a 320 miliardi di parametri completamente offline.
È una capacità che cambia radicalmente il tipo di modelli eseguibili su un computer desktop. Con una quantizzazione a 4 bit, una configurazione di questo genere può infatti contenere modelli che fino a poco tempo fa richiedevano infrastrutture server o acceleratori professionali con quantità molto superiori di memoria. GMKtec cita esplicitamente l’esecuzione locale di LLM fino a 320B, anche se compatibilità e velocità dipendono dal modello utilizzato, dal livello di quantizzazione e dall’ottimizzazione software.
Il protagonista hardware è il Ryzen AI Max+ PRO 495, soluzione che AMD colloca al vertice della propria piattaforma Gorgon Halo. Il chip integra 16 core Zen 5 e 32 thread, raggiunge una frequenza boost di 5,2 GHz e abbina alla CPU una Radeon 8065S con 40 Compute Unit basata su architettura RDNA 3.5. A completare il quadro c’è una NPU XDNA 2 capace di arrivare a 55 TOPS.
Il punto forte di Gorgon Halo non è però un incremento rivoluzionario delle prestazioni della CPU. Il vero salto in avanti riguarda infatti la memoria, con i 192 GB condivisi tra CPU e GPU che possono essere utilizzati in modo molto più flessibile rispetto alla classica configurazione di un PC con RAM di sistema e VRAM separata. Nel caso dell’EVO-X5 Pro, fino a 160 GB possono essere assegnati alla GPU, lasciando il resto al sistema operativo e alle applicazioni.
Ne risulta un’architettura particolarmente adatta all’inferenza degli LLM. Quando si esegue localmente un modello linguistico, infatti, una parte enorme delle risorse necessarie serve semplicemente a mantenere nella memoria i pesi del modello. A parità di quantizzazione, aumentare la memoria significa quindi poter caricare modelli molto più grandi senza ricorrere a una scheda grafica professionale con una quantità enorme di VRAM.
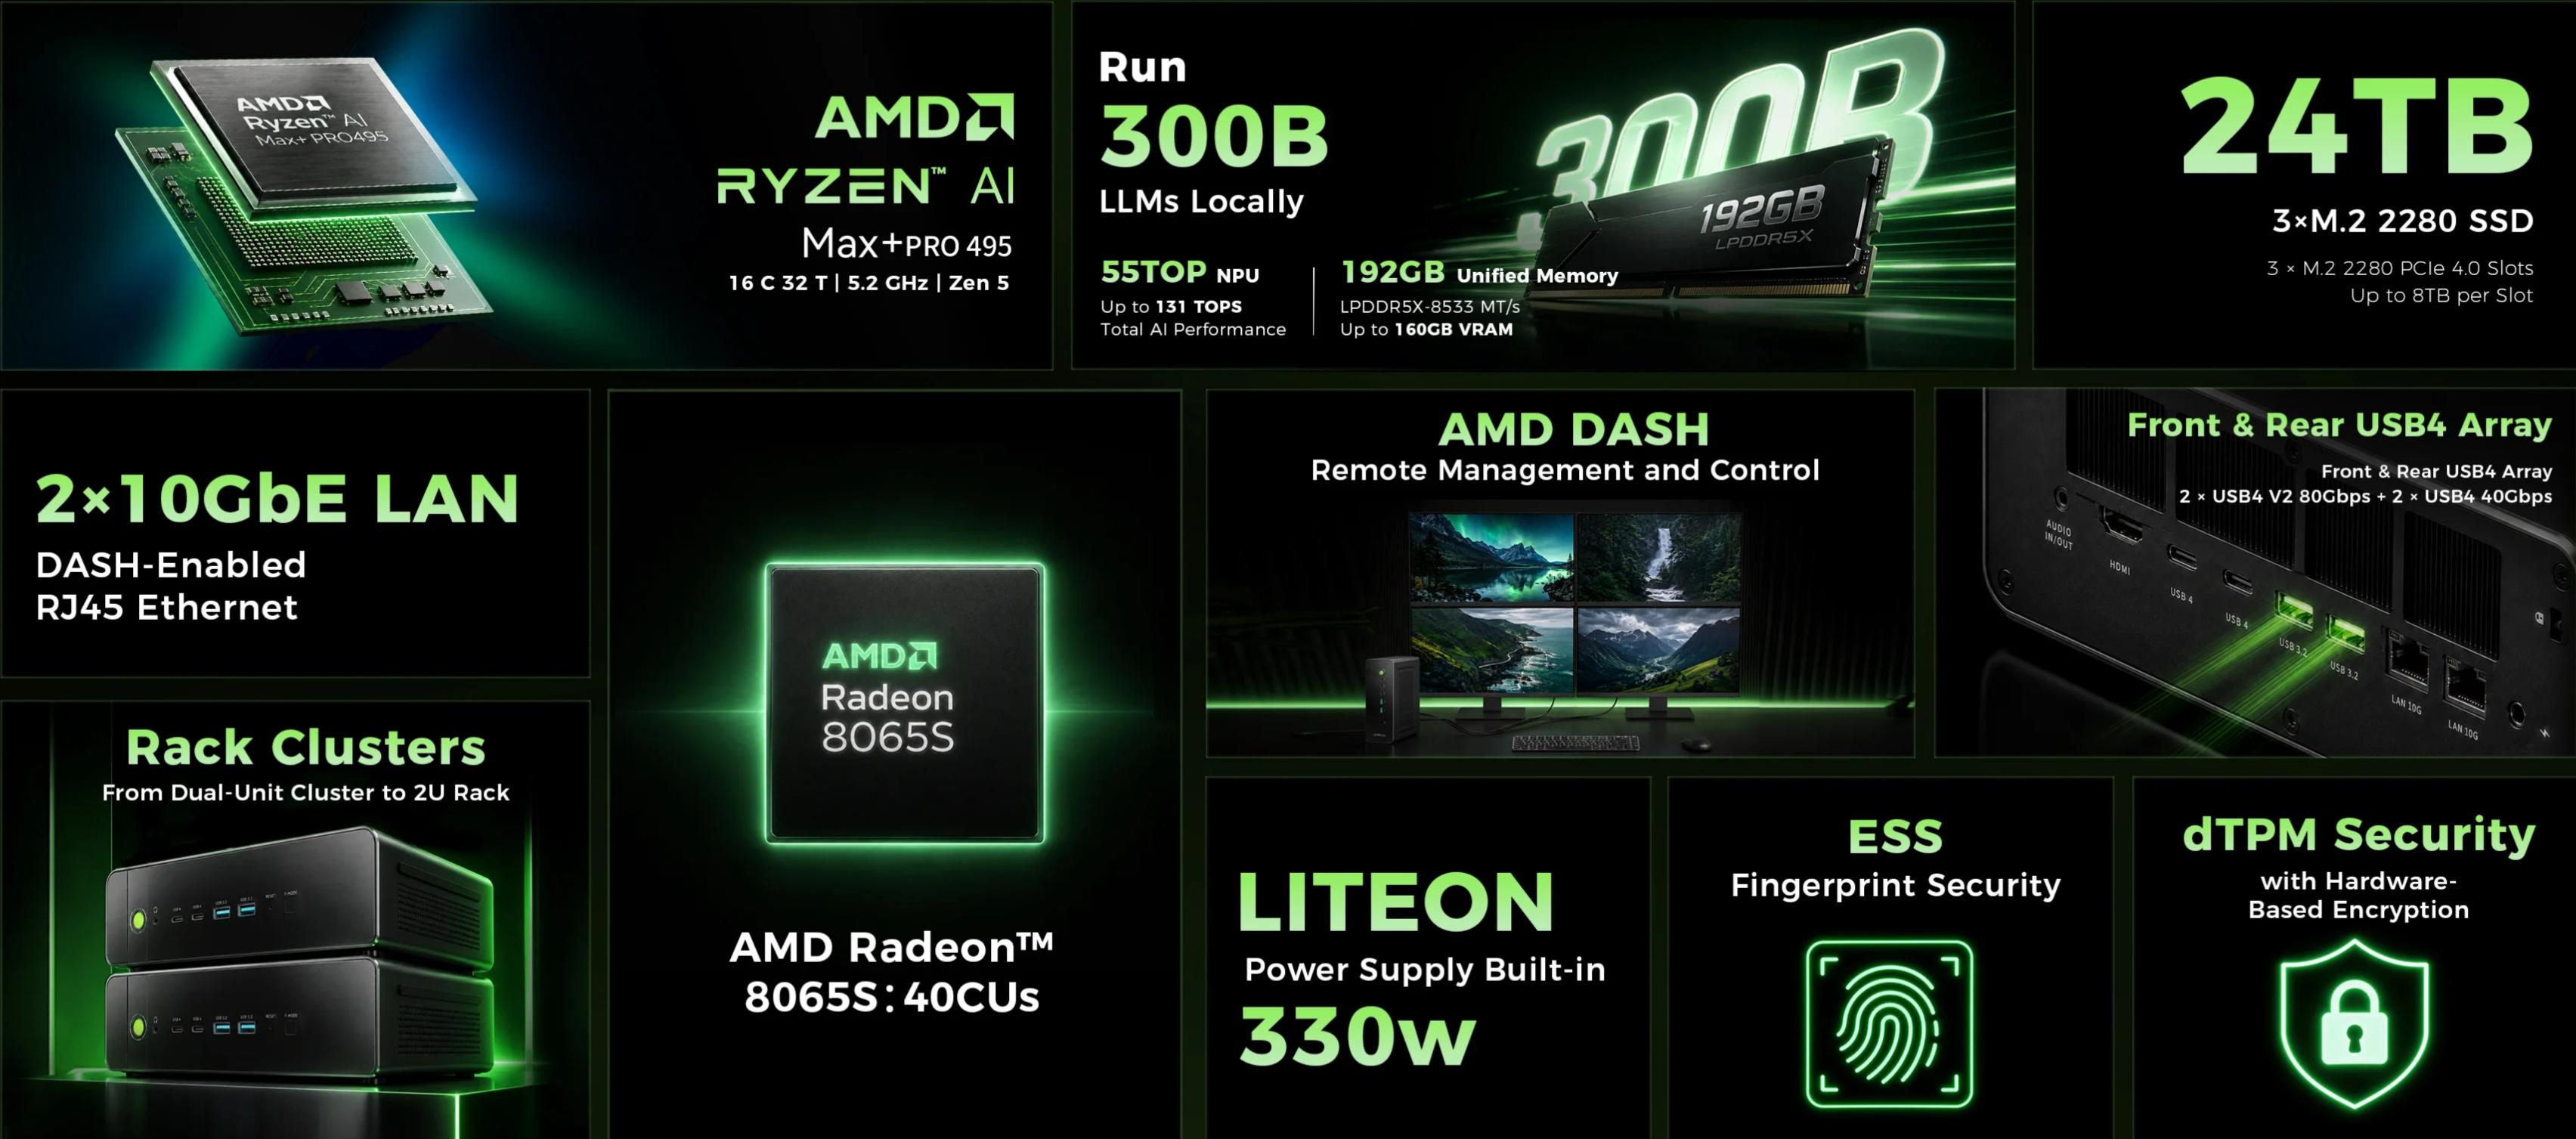
La LPDDR5X raggiunge inoltre 8.533 MT/s, con una larghezza di banda dichiarata di circa 273 GB/s. Il dato è superiore ai 256 GB/s della precedente piattaforma Strix Halo, ma non abbastanza da trasformare Gorgon Halo in un sistema drasticamente più veloce nell’inferenza. Il vantaggio principale rimane dunque la capacità, mentre l’aumento della banda può tradursi in un miglioramento più contenuto nella velocità di generazione dei token.
Questo dettaglio è importante perché poter eseguire un modello è diverso da poterlo eseguire rapidamente. L’EVO-X5 Pro può caricare LLM enormi, ma le prestazioni effettive dipendono fortemente dalla quantizzazione, dal motore di inferenza e dalla capacità del software di sfruttare CPU, GPU e memoria unificata.
L’EVO-X5 Pro dispone inoltre di tre slot M.2 PCIe 4.0 per una capacità complessiva dichiarata fino a 24 TB, due porte Ethernet da 10 GbE, USB4 e supporto per GPU esterne e configurazioni multi-sistema. Il raffreddamento utilizza una camera di vapore abbinata a tre ventole, con tre modalità operative per gestire carichi prolungati. Il sistema integra inoltre AMD DASH per la gestione remota e un modulo TPM 2.0 dedicato, caratteristiche che lo rendono più interessante anche per piccoli ambienti professionali.
Tutta questa memoria ha però un costo molto elevato. Il modello EVO-X5 Pro con 192 GB di RAM e SSD da 2 TB costa 6599 euro, mentre la versione con 4 TB arriva a 6899 euro. Il problema è legato soprattutto alla disponibilità della memoria LPDDR5X, la cui domanda è stata spinta enormemente dal boom dell’intelligenza artificiale.
Gorgon Halo porta quindi sul desktop una capacità di memoria sufficiente per affrontare modelli linguistici da centinaia di miliardi di parametri, ma lo fa a un prezzo che lo allontana nettamente dal mercato dei normali PC. La concorrenza di NVIDIA si sta muovendo nella stessa direzione con sistemi basati sul GB10, ma anche in quel caso l’aumento dei prezzi delle workstation AI sta rendendo sempre più costoso portare l’inferenza avanzata fuori dai data center.


