Claude Opus 5.5 offre prestazioni “Fable” a un costo ridotto del 40%
Anthropic ha presentato Claude Opus 5.5, intervenendo contemporaneamente su prestazioni, velocità e soprattutto costi di utilizzo. Secondo l’azienda, il nuovo modello raggiunge prestazioni paragonabili a Claude Fable 5.1 nella maggior parte delle attività, ma con un costo operativo tipico inferiore di circa il 40% rispetto a Opus 5, mentre la generazione delle risposte è oltre il 30% più veloce.
Il cambiamento più evidente per sviluppatori e aziende riguarda però il listino API. Opus 5.5 costa 4 dollari per milione di token in ingresso e 20 dollari per milione di token in uscita, contro i precedenti 5 e 25 dollari di Opus 5. La riduzione è quindi del 20% su entrambe le componenti. Ancora più consistente è il taglio applicato ai token presenti nella cache, il cui costo scende a 0,20 dollari per milione, con una riduzione del 60%.
La differenza tra il prezzo per token e il risparmio complessivo dichiarato da Anthropic è importante. Il 40% in meno sui workload tipici non deriva esclusivamente dal nuovo listino, visto che Opus 5.5 dovrebbe completare determinate attività utilizzando meno token e meno passaggi rispetto al predecessore. Per gli agenti software, dove una singola operazione può richiedere numerose chiamate al modello e l’utilizzo ripetuto dello stesso contesto, questo aspetto può incidere parecchio sulla fattura finale.
Il coding resta il terreno principale
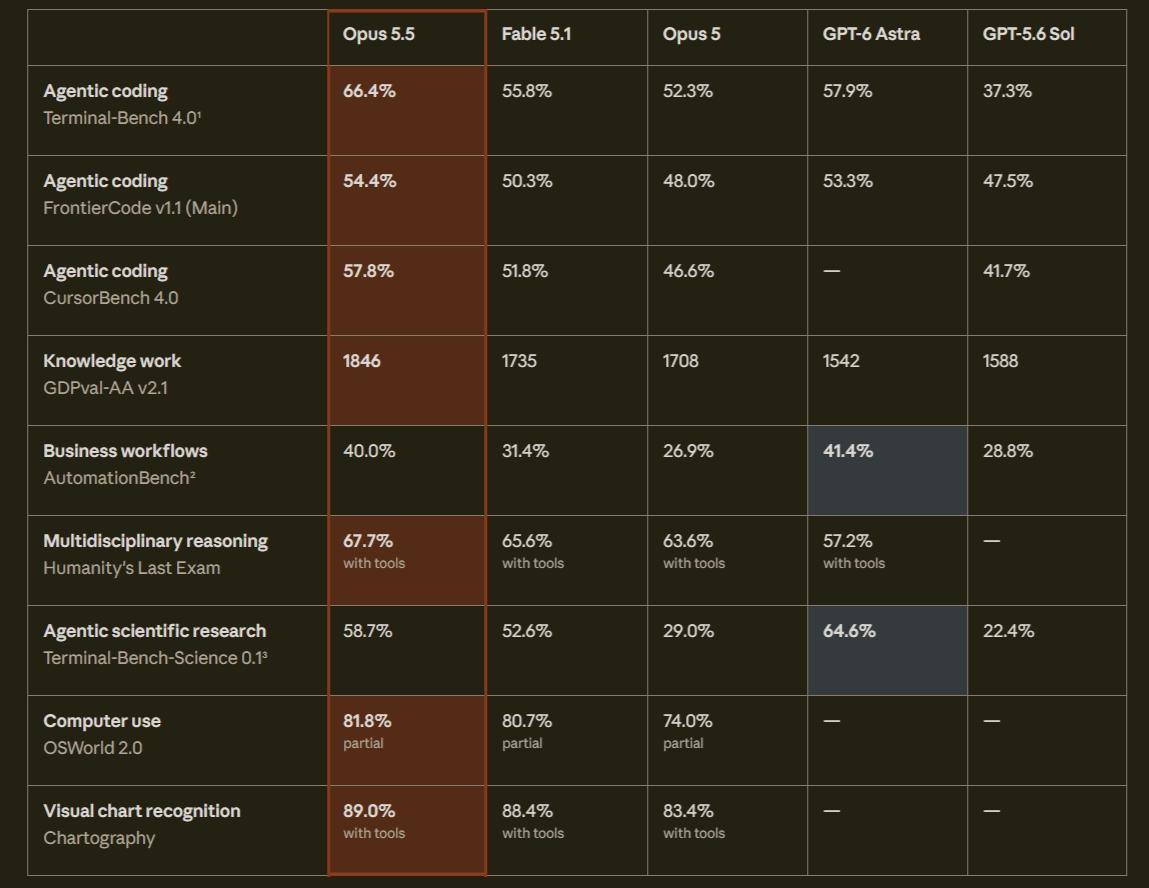
Opus 5.5 è stato progettato con una forte attenzione alle attività agentiche e allo sviluppo software. Nel benchmark Terminal-Bench 4.0, dedicato proprio alla capacità di operare attraverso il terminale, il modello ha raggiunto il 66,4%, rispetto al 55,8% attribuito da Anthropic a Fable 5.1. Su AutomationBench, invece, il tasso di completamento delle attività arriva al 40%, contro il 26,9% di Opus 5.
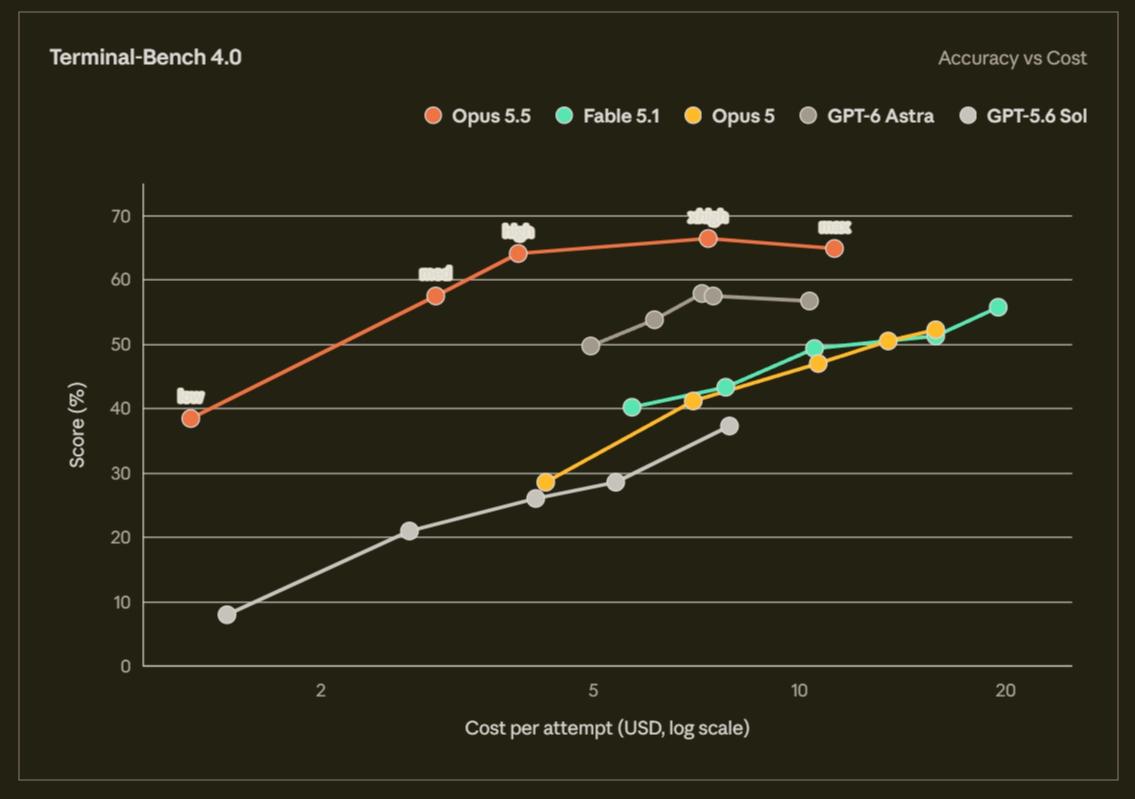
Il dato più interessante, tuttavia, riguarda il modo in cui il modello arriva al risultato. Anthropic riporta che nei test condotti con GitHub, Opus 5.5 ha risolto più attività da terminale rispetto a Opus 5 utilizzando meno della metà dei passaggi. In un ambiente agentico questo significa ridurre le chiamate agli strumenti, le occasioni di errore e le iterazioni necessarie per correggere un’operazione fallita.
La capacità di gestire attività lunghe e articolate emerge anche da alcuni test reali citati dall’azienda. Un utilizzatore ha completato in meno di una giornata una migrazione su una base di codice di circa 680.000 righe, un’attività che Anthropic stima avrebbe richiesto settimane di lavoro a un team di ingegneri. Si tratta naturalmente di un caso riportato dal produttore e non di una misura generalizzabile, ma evidenzia il tipo di workflow verso cui Opus 5.5 viene indirizzato.
Più efficiente nella ricerca e nel knowledge work
Il miglioramento non riguarda esclusivamente il software engineering. Nel benchmark Terminal-Bench-Science 0.1, Opus 5.5 ha ottenuto il 58,7%, contro il 29% di Opus 5. Nel test GDPval-AA v2.1, orientato alle attività professionali e al knowledge work, il modello raggiunge invece un punteggio Elo di 1846, contro 1708 per il predecessore. Su Humanity’s Last Exam, utilizzando strumenti esterni, Anthropic riporta un risultato del 67,7%.
Un altro elemento sul quale la società pone l’accento è la sintesi delle risposte. Secondo valutazioni condivise da alcuni clienti, Opus 5.5 tende a mettere le informazioni più importanti all’inizio e a ridurre la verbosità senza compromettere l’accuratezza. In un contesto aziendale questo può diventare un vantaggio concreto, considerando che un assistente che arriva più rapidamente al punto richiede meno interazioni e rende più leggibili i risultati prodotti.
Sicurezza e disponibilità
Anthropic ha lavorato anche sulla sicurezza del modello. Nei propri test comportamentali automatizzati, l’azienda afferma che Opus 5.5 ha ottenuto il risultato migliore tra i modelli finora sottoposti alla propria metodologia di valutazione. I tentativi di aggirare i confini di contenimento sarebbero diminuiti dell’85% rispetto a Opus 5, mentre la resistenza ai prompt injection avrebbe raggiunto livelli comparabili a Fable 5.1 nel benchmark Gray Swan.
Restano restrizioni specifiche per gli impieghi più sensibili, con le attività di cybersecurity considerate ad alto rischio che continuano a essere soggette a limitazioni e una parte di esse viene indirizzata verso modelli differenti. Analogamente, gli utilizzi biologici ritenuti più delicati sono sottoposti a controlli e programmi di verifica.
Claude Opus 5.5 è disponibile attraverso la Claude Developer Platform con identificativo claude-opus-5-5 e viene distribuito anche tramite Amazon Web Services, Google Cloud e Microsoft Azure. Anthropic ha inoltre annunciato l’arrivo nelle prossime settimane di Claude Sonnet 5.5 e Claude Haiku 5.5, completando una nuova articolazione della famiglia Claude 5.5 per differenti esigenze di prestazioni e costo.


