La belga Aikido rilascia un modello AI open weight per la cybersecurity sovrana
Adottare i modelli linguistici di ultima generazione all’interno della sicurezza informatica significa scontrarsi con la sovranità dei dati personali e strategici. Per organizzazioni bancarie, strutture sanitarie o infrastrutture industriali critiche dotate di reti del tutto prive di connessione a internet, l’invio di codice sorgente, documentazione d’architettura o report sulle vulnerabilità verso server di inferenza terzi costituisce infatti un azzardo inaccettabile.
L’unico modo per sfruttare l’AI difensiva rimane portarla direttamente all’interno del proprio perimetro operativo e la società belga Aikido Security affronta questa sfida lanciando Altar, un modello a pesi aperti progettato per eseguire penetration test autonomi anche in contesti isolati. L’ostacolo principale per questo tipo di applicazioni risiede nel gap di deploy dei modelli open weight di fascia alta.
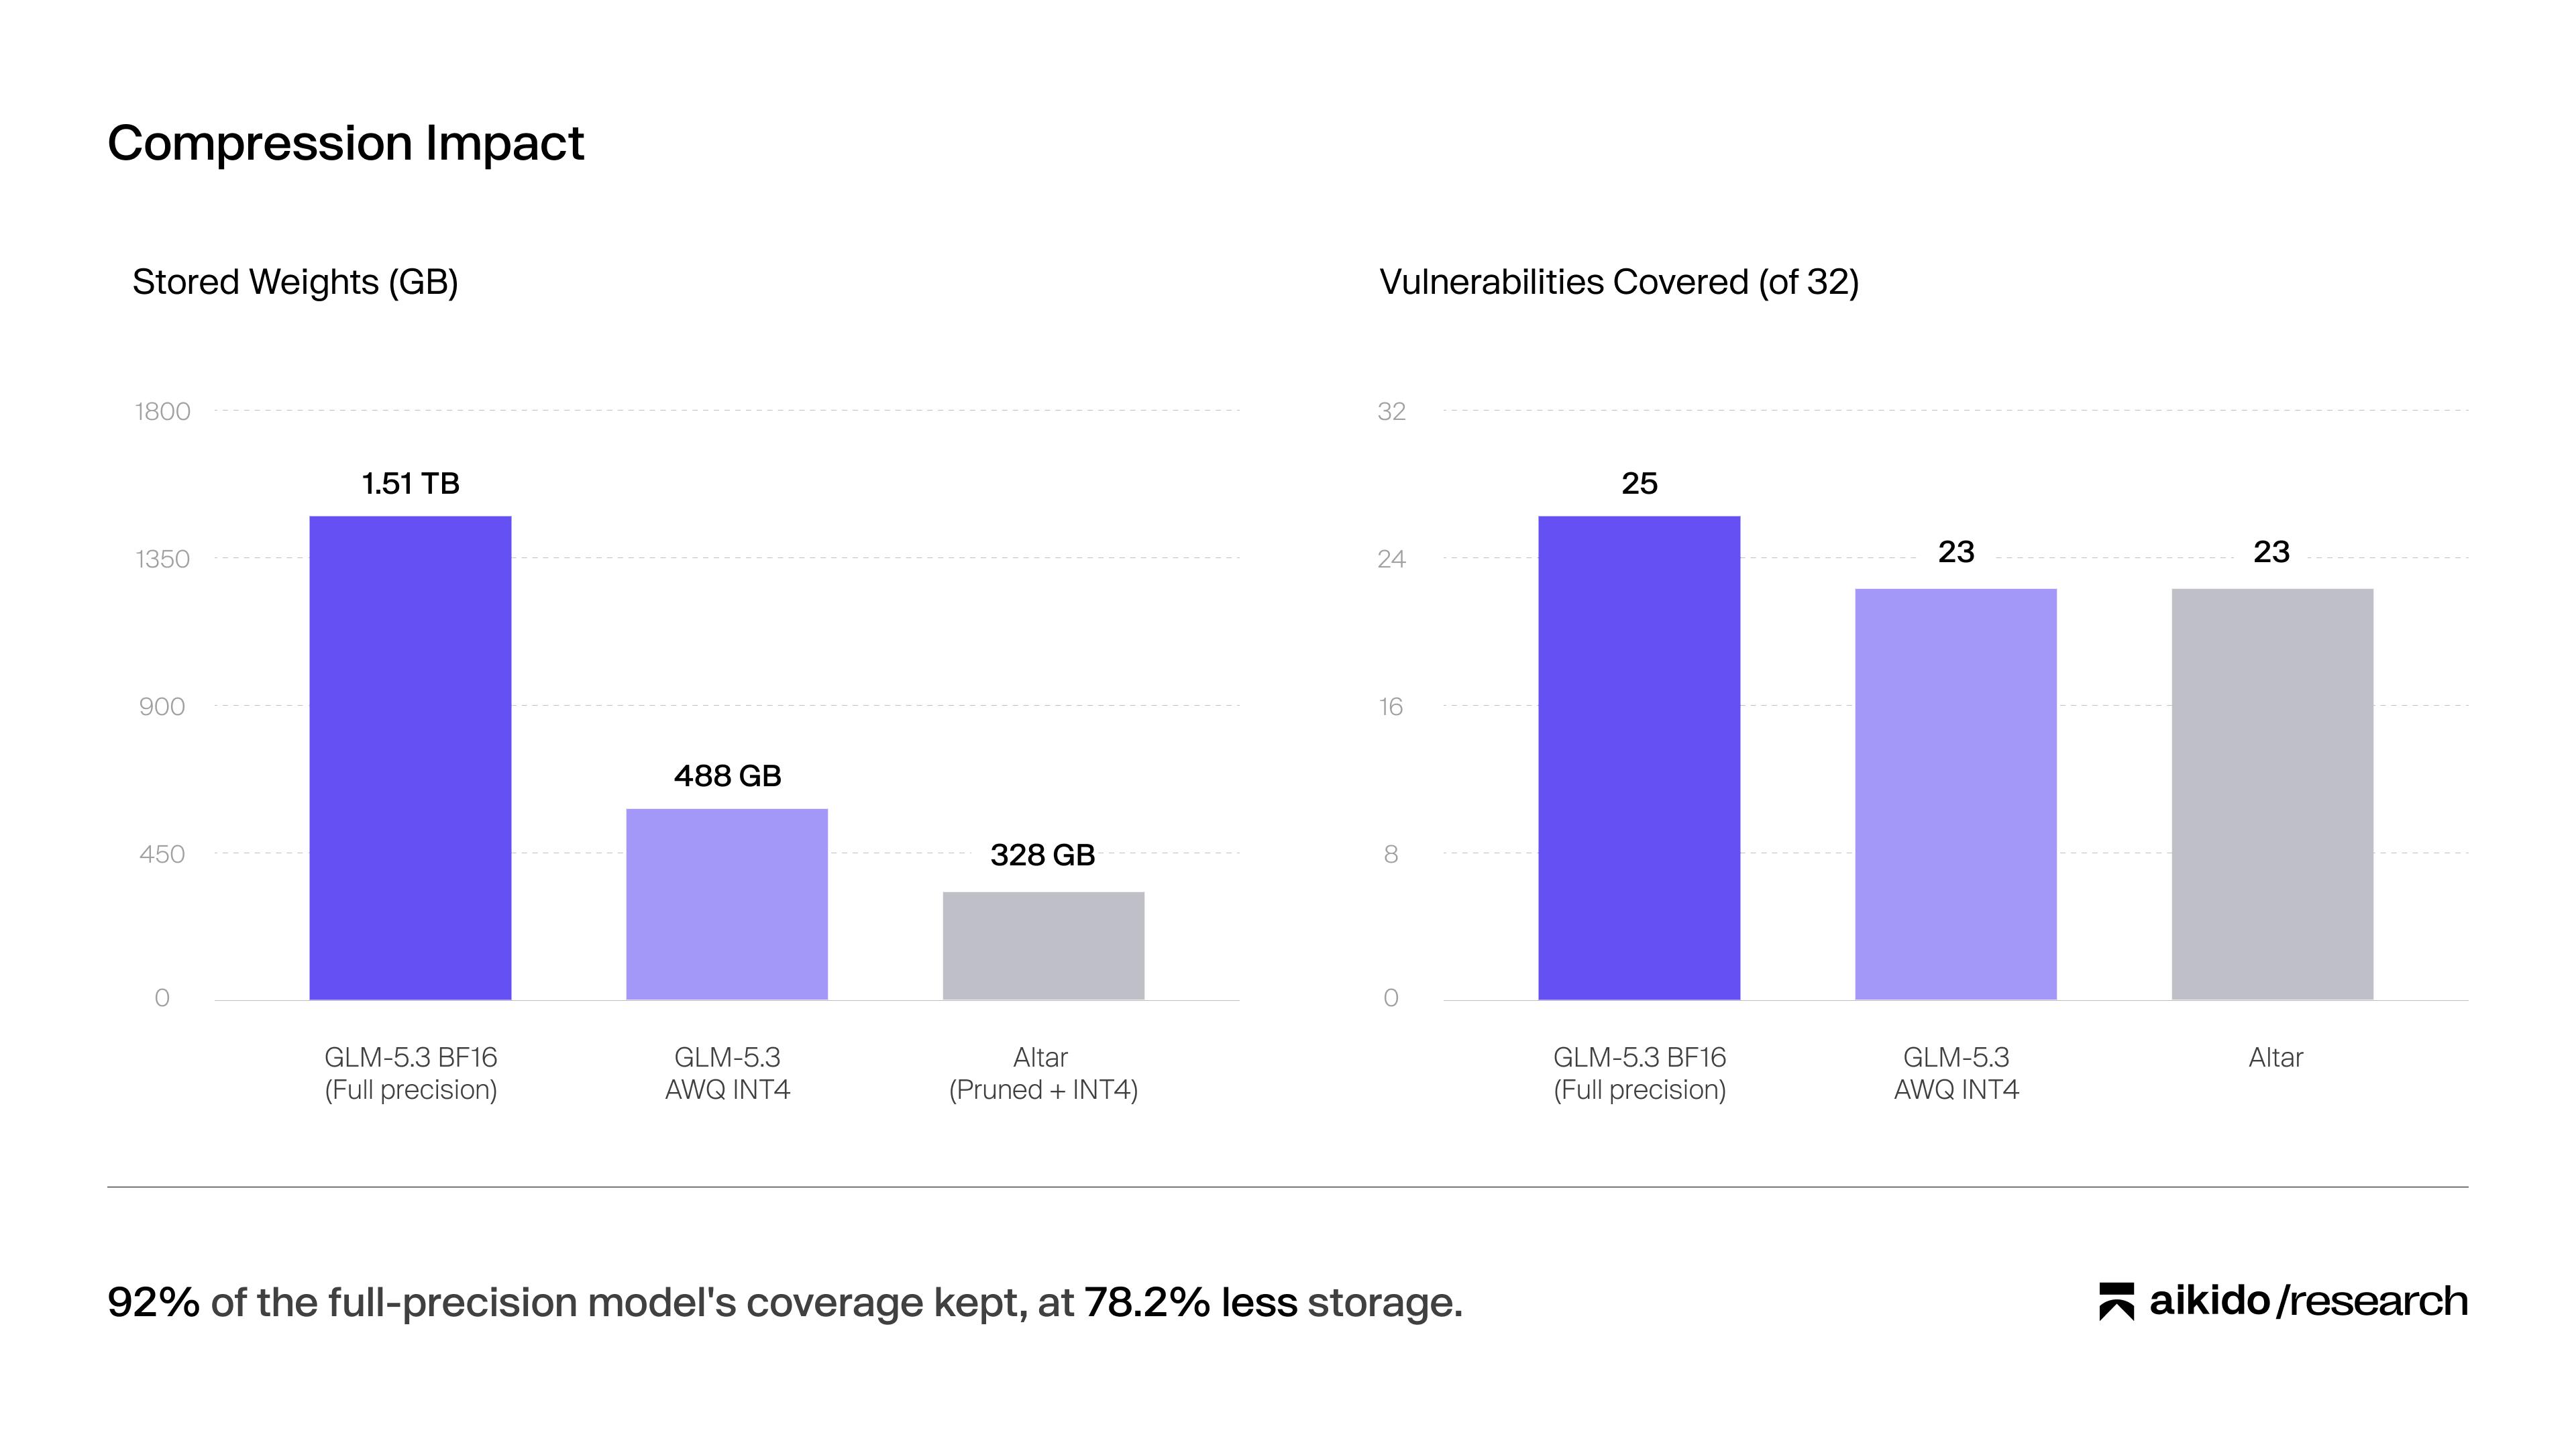
Architetture avanzate come GLM-5.3 richiedono infatti 1,51 Terabyte di memoria alla massima precisione per funzionare e quando si impiegano sistemi ad agenti, il consumo di risorse aumenta rapidamente. Gli agenti infatti salvano continuamente la cronologia delle azioni e del contesto, la quale deve risiedere nella VRAM della GPU assieme alle informazioni del modello stesso.
Se la dimensione del modello assorbe la maggior parte delle risorse hardware, resta poco spazio operativo per far lavorare simultaneamente più agenti. Analizzando la struttura di modelli complessi come GLM-5.3, basati su architetture Mixture-of-Experts, emerge però un margine di efficientamento. Questi sistemi contengono infatti centinaia di sottoreti specializzate, ma solo una minima frazione viene effettivamente consultata durante un’analisi di sicurezza.
Il costo in termini di memoria rimane invariato per ogni singola richiesta, imponendo l’allocazione di risorse inutilizzate. Ridurre le dimensioni senza intaccare le capacità di analisi logica e di comprensione del testo scritto si rivela quindi la chiave per rendere sostenibile l’esecuzione locale.
Per comprimere la risorsa senza compromettere le prestazioni tecniche, Altar ricorre a un doppio intervento di ottimizzazione strutturale. L’impronta di partenza viene prima quantizzata a 4-bit per i pesi mantenendo le attivazioni a 16-bit tramite la tecnica AWQ, riducendo lo spazio necessario a 488,2 Gigabyte. Successivamente, viene applicato REAP (Router-weighted Expert Activation Pruning), una metodologia sviluppata da Cerebras per ridurre drasticamente il peso del modello (i requisiti di memoria VRAM), eliminando fisicamente gli “esperti” interni meno utili o ridondanti e mantenendo al contempo intatte le capacità dell’IA
La selezione viene guidata ed equilibrata analizzando sia i dati reali dei penetration test, che comprendono informazioni dettagliate su vulnerabilità sfruttabili, percorsi di compromissione e prove concrete di attacco, sia documentazione in varie lingue, così da salvaguardare la comprensione delle regole di business oltre alla sola scrittura del codice. Questo processo consente di eliminare 88 dei 256 esperti complessivi presenti nei livelli del modello.
La versione finale di Altar pesa 328 Gigabyte, segnando un abbattimento complessivo del 78,2% rispetto al modello iniziale da 1,51 Terabyte e un’ulteriore riduzione del 32,8% rispetto al solo passaggio di quantizzazione.
Per eseguire il sistema, sono sufficienti quattro schede H200 affiancate dall’engine vLLM e le misurazioni condotte su un benchmark interno di 32 vulnerabilità diffuse su 30 repository dimostrano la tenuta del sistema, visto che a fronte della perdita di circa un punto percentuale nel recall medio rispetto al riferimento quantizzato, Altar ha individuato 23 falle, mantenendo il 92% della copertura originaria dell’architettura madre.


